Jev modèle System One : guide complet, skill et kit à télécharger
Quand j'ai vu les deux chiffres s'afficher côte à côte, j'ai cru à une erreur de la console. Un modèle qui décide en 70 à 500 millisecondes, qui facture 0,042 dollar par million de tokens en entrée et qui rend ses sorties gratuites. Et surtout, un modèle qui ne peut pas halluciner, parce qu'il ne génère pas des mots : il choisit.
Ça s'appelle Jev, c'est le premier modèle d'une nouvelle classe appelée System One, et ça change la façon de traiter la montagne d'enregistrements qui n'attend qu'une interface intelligente. Emails, tickets, leads, demandes, anomalies : tout ce qui hésite entre « traiter » et « ignorer ». Ce guide vous donne la mécanique, les chiffres réels et un kit de démarrage téléchargeable pour l'installer en dix minutes.
Le problème que Jev résout : l'IA qui parle au lieu d'agir
Les modèles de langage ont atteint un niveau qu'on n'imaginait pas il y a cinq ans. Ils rédigent, raisonnent, traduisent, corrigent. Mais dès qu'on veut les brancher sur un pipeline de production, personne ne sait exactement où ils s'arrêtent.
Un email arrive à trois heures du matin. Doit-il déclencher une réponse, être transféré au service billing, ou finir dans le dossier des indésirables ? C'est une décision. Elle se répète des milliers de fois par jour, elle est triviale à énoncer, et pourtant elle coûte soit un humain qui interrompt son travail, soit un LLM dont le ticket revient à un dollar dès qu'on le couple à des appels d'outils.
L'équipe derrière Jev vient de là. Diogo Almeida, cofondateur et CEO, a passé des années chez OpenAI avant de fonder TypeSafe. Le constat est simple : la partie « chat avec un génie » est réglée, la partie « les décisions opérationnelles sont prises toute seules » ne l'est pas.
Le nom System One n'est pas un hasard. C'est une référence directe au travail de Daniel Kahneman : le Système un, c'est la pensée rapide, intuitive, quasi instantanée. Le Système deux, c'est la réflexion lente et profonde. Les LLM sont de formidables Systèmes deux : lents, verbeux, coûteux. Jev est un Système un : rapide, économique, et conçu pour rendre un verdict, pas un monologue.
Jev, c'est quoi exactement ?
Jev est un modèle de la classe System One : il prend une entrée d'état non structuré (un email, un tableau, une page, une liste d'événements) et produit une sortie typée et probabiliste. En pratique, trois sorties possibles, que je détaille un cran plus bas.
Trois décisions d'architecture méritent votre attention.
Un entraînement orienté décision. TypeSafe ne parle pas de « prompt engineering », il parle de RLCD : Reinforcement Learning for Calibrated Decisions. L'apprentissage par renforcement est centré sur la qualité de la décision finale et sur la calibration de la confiance. Autrement dit, quand Jev affirme que c'est du spam à 97 %, il a vraiment raison 97 fois sur 100. La confiance n'est pas un vague sentiment, elle est calibrée sur les données d'entraînement.
Un échantillonneur parallèle. Un LLM classique génère du texte de manière séquentielle, un token après l'autre. C'est ce qui le rend lent et cher sur les petites tâches. Jev utilise un échantillonneur ensemble qui produit les décisions en parallèle. Les chiffres officiels donnent 70 à 500 millisecondes par décision, contre 3 à 329 secondes pour les grands modèles de chat. Sur dix mille tâches types, TypeSafe annonce en moyenne 193,6 fois plus rapide et 444,6 fois moins cher que les modèles de référence utilisés dans ses benchmarks.
Une garantie structurelle contre l'hallucination. C'est le point le plus fort, et celui qui mérite le plus de nuances. Comme la sortie est contrainte par un type et un vocabulaire fini, le modèle ne peut pas inventer un texte libre. Il ne peut pas produire un mot hors du contrat, simplement parce que le contrat bloque la génération. Le résultat est valide par construction, dans 100 % des cas. C'est du « type-safe » : la sortie est conforme au schéma, point. La nuance, on y vient, c'est qu'une sortie valide peut quand même être erronée.
Le tarif qui change tout
Le modèle se paie à l'usage, et c'est ce qui le rend viable en production.
- L'entrée coûte 0,042 dollar par million de tokens, pour le modèle le plus cher de la gamme. Certains modèles de la famille sont moins chers encore.
- Les sorties sont gratuites. Oui, gratuites. Parce que la sortie est un choix, pas une génération de texte.
- La latence réelle se situe entre 70 et 500 millisecondes par décision.
Pour visualiser : un traitement de mille emails de spam à environ un centime. La même classification confiée à un modèle frontier classique, c'est plusieurs dollars. Quand vous multipliez par les flux entrants d'une entreprise, l'écart n'est plus un détail, c'est la différence entre un pipeline qui tourne et un pipeline qu'on rate pour des raisons comptables.
Les trois sorties de Jev
Jev ne « rédige » pas. Il classifie, et il explique sa certitude.
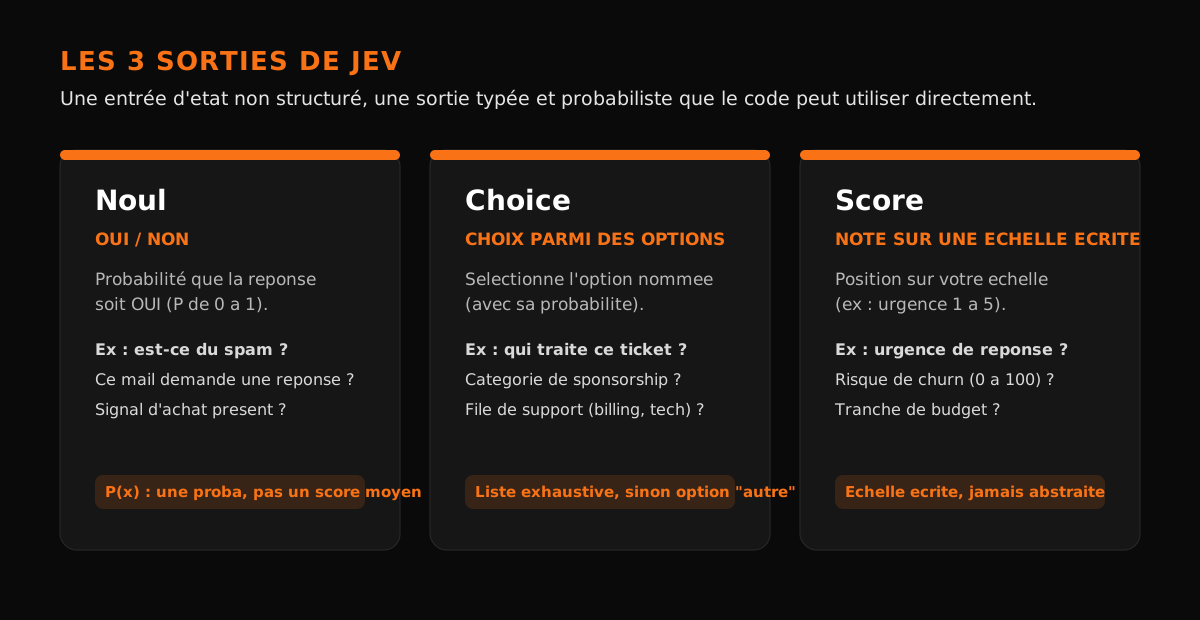
Noul, la sortie oui/non. Une question binaire, une probabilité entre zéro et un. Est-ce du spam ? Ce client va-t-il partir ? Ce message exige-t-il une réponse ? La probabilité n'est pas un score marketing, c'est une calibration. Entre 0,51 et 0,99, elle porte une information réelle que votre code peut exploiter.
Choice, le choix parmi des options. Vous définissez la liste des options, avec une option « autre » si la liste n'est pas exhaustive. Qui traite ce ticket : facturation, support, technique, direction ? Quelle est la catégorie de cette demande de partenariat ? Jev renvoie l'option choisie et sa probabilité.
Score, la position sur une échelle écrite. L'échelle doit être écrite en toutes lettres, pas abstraite. Quel est le niveau d'urgence, de 1 à 5, avec la définition de chaque niveau ? Quel est le risque de churn, de 0 à 100 ? Pourquoi une échelle écrite ? Parce que chaque niveau a une définition précise, et le modèle sait se positionner entre deux bornes.
Regardez ce que ça change par rapport à un prompt « réponds en JSON ». Avec Jev, le schéma n'est pas une supplique, c'est le contrat d'exécution. Votre code sait exactement quelle structure il va recevoir, et combien se fier à chaque valeur.
Les cinq usages qui justifient le modèle
Voici la liste des usages qu'on voit ressortir partout, avec les ordres de grandeur observés par rapport à un LLM frontier en mode raisonnement.
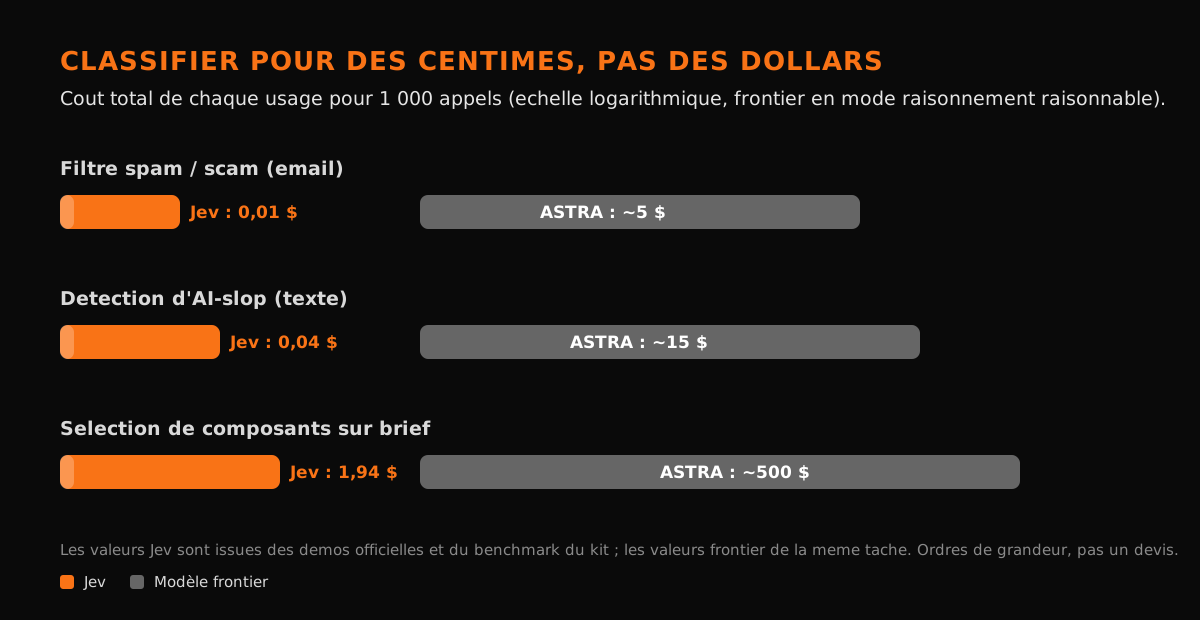
Le filtrage du spam et des arnaques. Mille emails traités en quelques secondes pour environ un centime, contre plusieurs dollars avec un gros modèle. C'est l'usage canonique : décision binaire, volume énorme, coût qui explose ailleurs.
Le triage, le churn, le support, l'accueil des nouveaux leads. Le classique « qui traite ce message et avec quelle priorité ». Quelques centimes pour un volume qui ferait un appel API coûteux avec un modèle de chat, et la sortie tombe directement dans vos files.
La détection d'AI-slop. Repérer les contenus génériques générés par IA à grande échelle, pour un coût ridicule. Les tests mentionnent des ordres de grandeur autour de 4 centimes contre 15 dollars pour la même tâche confiée à un modèle frontier.
La sélection d'un design system. L'exemple qui m'a le plus marqué : choisir le meilleur composant ou la meilleure bibliothèque parmi des centaines d'options, à partir d'une description du besoin. Pas une recherche par mots-clés, mais un jugement sémantique. Trois cents systèmes évalués pour environ 2 dollars, là où le même travail par un LLM classique partait dans les centaines de dollars.
Le routing de modèles. Décider, pour chaque requête, quel modèle doit la traiter. C'est une méta-décision parfaite pour une System One : un choix, rapide, pas cher, récurrent.
Le point commun : une décision répétée, un nombre fini de possibilités, une latence courte. Dès que votre problème ressemble à ça, Jev est candidat.
Une autre classe de résultats : ces apps qu'on construisait avec des bases vectorielles
Il y a un discours qui dit qu'il faut un RAG, une base vectorielle et potentiellement des centaines de milliers de dollars d'infrastructure pour qu'une application réponde avec pertinence. Sur les problèmes de classification, c'est un mythe coûteux. Prenez les exemples démontrés dans des outils conçus avec Jev.
Un sélecteur d'emoji et un « Netflix finder ». On pose une description à l'anglaise : « donnez-moi un film qui ressemble à ça », « l'emoji qui correspond à ce message », et l'outil indexe les résultats à la volée, sans base vectorielle, sans pipeline RAG. L'indexation instantanée, c'est le point : la recherche est calculée en direct, pas pré-calculée.
Un outil de scoring d'annonces publicitaires. Lire quatre cents annonces, noter les angles, les accroches, le format, et ressortir ce qui a de la force. Le tout pour quelques centimes, là où un frontier coûtait des dizaines de dollars par analyse. Pour un consultant ou une agence qui trie des librairies d'annonces chaque semaine, c'est un outil de veille permanent qui ne coûte presque rien.
Un chercheur de composants UI. Le plus impressionnant. Un outil qui scanne 255 composants du catalogue 21st.dev et renvoie le bon composant pour un besoin sémantique : « un toggle mensuel/annuel », « une carte de tarification avec badge promo ». Environ 750 appels par recherche, une à deux secondes, et un jugement qui porte sur le sens, pas sur les mots. C'est exactement ce qu'un LLM séquentiel ferait en beaucoup plus cher et beaucoup plus lent.
La leçon est stratégique : pour toute décision qui a un nombre fini de réponses possibles, l'infrastructure lourde de recherche n'est pas nécessaire. Un modèle System One suffit, avec latence en secondes et coût en centimes.
L'antihype : ce que Jev ne fait pas
Avant le kit, les limites. Parce qu'il y en a, et que les connaître évite les déceptions.
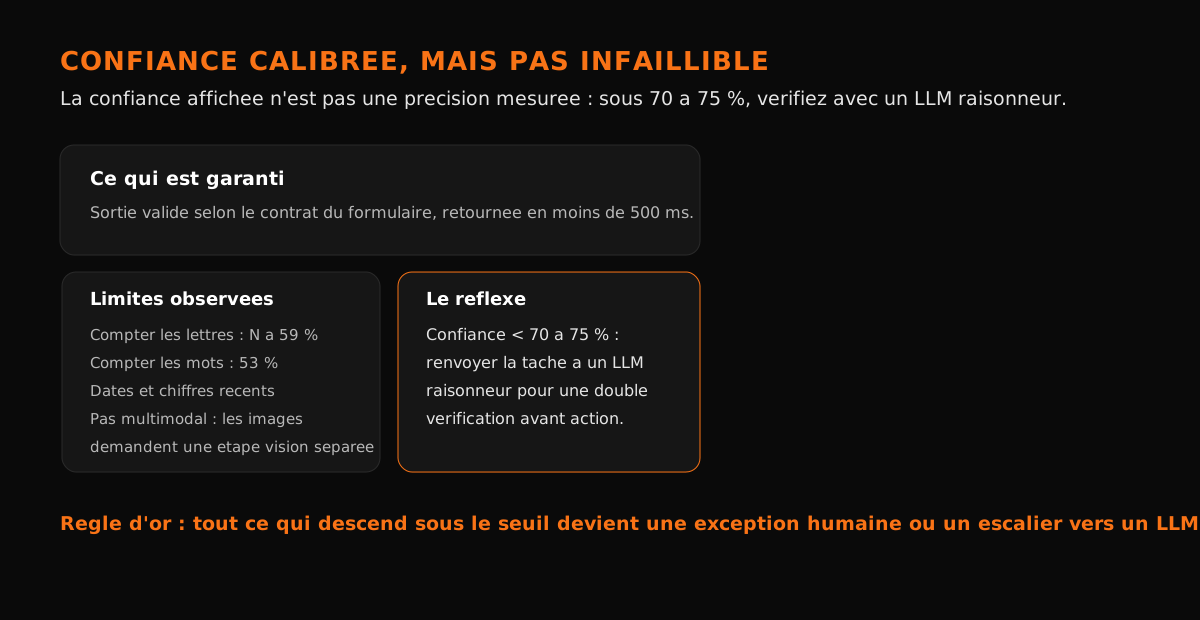
Jev n'est pas multimodal. Il traite le texte et les données structurées. Une image demande une étape de vision séparée, avec un autre modèle, avant de passer la transcription à Jev. Il faut le savoir pour concevoir le pipeline en conséquence.
Jev n'écrit pas de contenu. Ce n'est pas un outil de rédaction, de chatbot ou de génération. Inutile d'essayer de lui faire écrire un email de relance : ce n'est pas son métier. Son métier, c'est de choisir.
La confiance n'est pas une précision mesurée. La calibration dit que quand la confiance affichée est haute, la probabilité de se tromper est faible. Mais la confiance basse ne dit pas laquelle des options est la bonne : elle dit qu'il faut vérifier. C'est une règle d'or que je redonne plus bas.
Il y a des tâches où Jev échoue, et c'est normal. Sur des micro-tâches de comptage, la performance chute : compter la lettre N dans un texte tourne autour de 59 % de confiance, compter les mots autour de 53 %. Sur une date récente ou un ordre de grandeur pour lequel le contexte ne suffit pas, le modèle peut se tromper avec aplomb. Pourquoi ? Parce que ces tâches demandent un raisonnement que le modèle, calibré pour trancher vite, n'a pas effectué en profondeur.
La consigne est donc précise : si la confiance passe sous 70 à 75 %, ne laissez pas le flux agir. Renvoyez l'enregistrement vers un LLM raisonneur pour une double vérification, ou vers un humain. C'est le fameux escalier des décisions : Jev en bas, le raisonnement au-dessus, l'humain au sommet.
Le kit Jev : installable en dix minutes
Assez de théorie. Voici le kit ultra-actionnable que j'ai préparé, avec les formulaires prêts à l'emploi et le script qui fait tourner le batch. Il est téléchargeable, gratuit, et il ne coûte rien à tester grâce au dry-run.
Télécharger le kit Jev (zip, 16 fichiers)
Ce qu'il contient :
jev-handoff/SKILL.md: le skill complet à installer dans votre agent,jev-handoff/references/integration.md: les endpoints et les paramètres réels,jev-handoff/references/forms.json: les cinq formulaires de décision prête à l'emploi,jev-handoff/agents/openai.yaml: un template de configuration agent,jev-handoff/examples/*: des lots d'emails synthétiques par décision, pour tester sans rien déclencher,jev-handoff/scripts/jev_run.py: le runner qui envoie le batch au modèle.
L'installation, étape par étape
Deux prérequis. Une clé API OpenRouter (variable OPENROUTER_API_KEY), parce que le runner passe par le endpoint décisions d'OpenRouter, et Python 3.10 ou plus récent.
Copier le skill dans votre agent. Sous Claude Code, décompressez le zip et placez le dossier jev-handoff dans ~/.claude/skills/. Depuis un projet, vous l'invoquez avec /jev-handoff. Sous Codex, placez-le dans ~/.codex/skills/ et utilisez $jev-handoff. Le skill contient toute la procédure : choisir le bon formulaire, lister les batches, interpréter les sorties.
Lancer la première passe en dry-run. Le script refuse d'écraser un dossier de résultats existant, ce qui vous protège des doubles exécutions. Pour tester sans dépenser le moindre centime :
python3 scripts/jev_run.py --input examples/spam-emails.jsonl \
  --form examples/spam-form.json \
  --output results/spam-01 \
  --dry-run
Le dry-run affiche ce qui serait envoyé, le nombre d'enregistrements et le formulaire retenu, sans appeler le modèle. Une fois validé, vous retirez --dry-run et le batch part : quatre workers en parallèle, un timeout de soixante secondes par appel, et deux fichiers en sortie, results.jsonl avec chaque décision et la confiance associée, et summary.json avec l'agrégat.
Les cinq décisions du kit
Les formulaires couvrent les flux qui reviennent dans neuf entreprises sur dix.
Le filtrage spam et arnaques (Noul). Une probabilité que le message soit un spam ou une arnaque. Passe tout le flux entrant, ne retient que les signaux forts à supprimer ou à signaler.
Qui traite ce message (Choice). Vous définissez les propriétaires : facturation, support, technique, direction, sans réponse. Chaque option décrite par ses responsabilités, comme dans une vraie règle de gestion interne. Exemple typique : les partenariats et les interviews vont à un responsable, les bugs à un autre, la facturation à un troisième.
L'urgence de réponse (Score). Une échelle écrite de cinq niveaux, chacun avec sa définition. Les messages critiques sortent en quelques centaines de millisecondes, le reste attend l'ouverture suivante.
Le signal d'achat (Noul). Est-ce que ce lead ou ce message montre un signal d'achat ? C'est le formulaire qui nourrit vos campagnes de prospection sans faire exploser le coût de qualification.
Le type de sponsoring (Choice + Score). Pour les flux de partenariats : quel type de sponsoring, quelle fourchette de budget, les tranches étant écrites explicitement, par exemple un millier, cinq mille ou quinze mille dollars. C'est le genre de décision dont le coût de traitement par un humain dépasse largement la valeur du message.
Les critères se relisent tous dans forms.json, et vous les adaptez en deux minutes à vos propres règles, puisque le formulaire est un simple JSON.
Le benchmark réel du kit
J'ai mesuré le comportement du kit tel que fourni, le 19 septembre 2026, sur le même lot de vingt emails, répété cinq fois.
| Métrique | Jev 1.13 | GPT-6 Astra |
|---|---|---|
| Temps par lot de 20 emails | 2,60 à 2,99 s | 10,04 à 17,81 s |
| Coût par lot | 0,00223 $ | 0,70583 $ |
| Labels corrects | 100/100 | 100/100 |
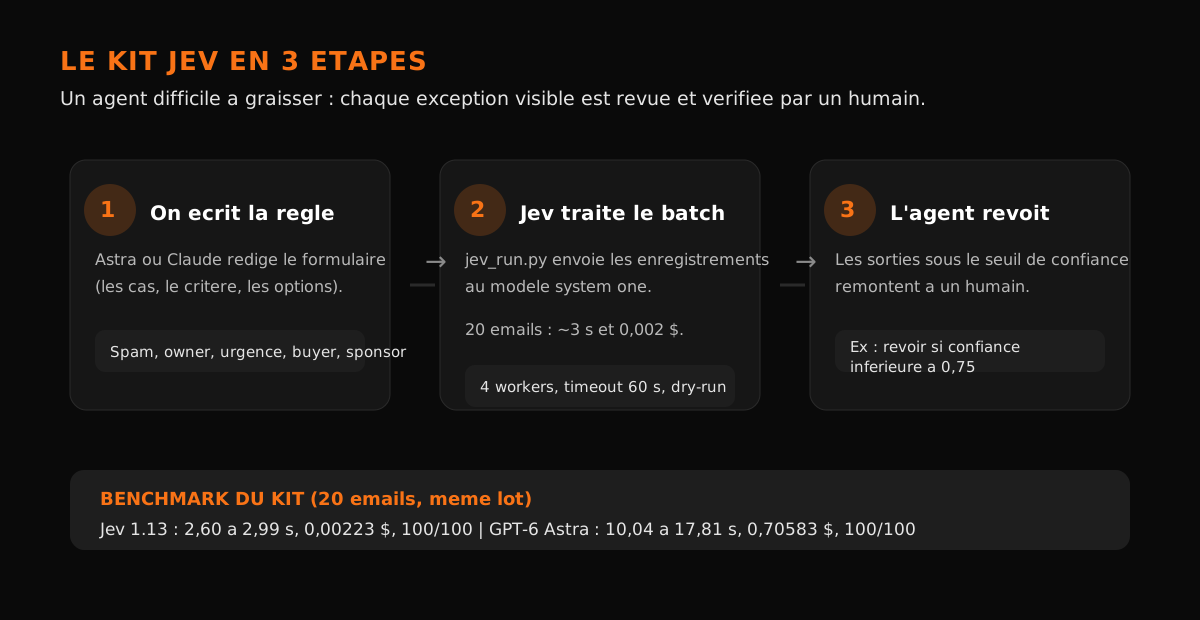
À précision égale, Jev est ici trois à six fois plus rapide et environ trois cents fois moins cher. Attention aux limites du test : vingt emails synthétiques, un seul scénario, un modèle en version 1.13, l'état d'environ 32 000 tokens pour le contexte et les questions. Votre volume réel peut changer les chiffres. Mais l'ordre de grandeur est cohérent avec tous les tests indépendants que j'ai pu lire.
La règle de révision est incluse dans le kit : en dessous d'un seuil de confiance (par exemple 0,75 pour la décision propriétaire), l'enregistrement sort du lot et remonte vers l'humain. Personne ne laisse une machine décider de tout, seule.
Ce que ça donne en conditions réelles
Les tests en conditions réelles sont les plus parlants, parce qu'ils éliminent le doute sur la démo.
Le traitement d'emails en volume. Un lot de vingt-quatre emails a été classé en 55 millisecondes pour un coût de 0,002 dollar. On compte mieux en plus gros : environ 1 700 emails par lot tournent autour de 0,19 dollar, là où un modèle de chat classique mettait environ sept secondes par email, soit deux heures pour faire ce que Jev fait en quelques secondes.
L'analyse d'une vidéo de 27 minutes. Le flux : transcription et OCR de chaque frame, puis passage dans Jev pour extraire les infos et les décisions. Vingt-sept minutes de vidéo en environ une minute et demie, y compris le floutage automatique des données confidentielles qui apparaissent à l'écran. C'est un exemple de pipeline hybride où Jev traite la décision pendant qu'un autre modèle gère la vision.
La préqualification des leads entrants. Les réponses tombent en 200 à 300 millisecondes par prospect. Un formulaire web, quelques champs, et la qualification se fait au fil de l'eau au lieu de s'accumuler dans un onglet.
La détection d'arnaques par SMS. Un lot traité en 541 millisecondes pour 0,002 dollar. Quand c'est votre mutuelle, votre banque ou votre opérateur qui vous écrit, le coût de l'erreur n'est pas le problème : la vitesse et la fiabilité de la classification, si.
Les agents de jeu et d'exploration. Les démos internes montrent Jev qui joue en continu (une session de jeu approximativement à sept dollars de l'heure, là où l'équivalent avec un grand modèle de raisonnement était hors de prix), qui résout des courses de « wiki racing » en enchaînant les choix, et qui garde 255 options en tête simultanément. Le paradoxe de Jevons, qui donne son nom à la difficulté, se retourne ici : quand un service devient 400 fois moins cher, sa consommation explose, et c'est exactement le but.
L'accès au modèle. Vous pouvez l'utiliser via la console de TypeSafe (le playground est parfois saturé aux heures de pointe), via le endpoint public d'OpenRouter pour les décisions, ou via l'API dédiée de TypeSafe. Le niveau gratuit de Vercel suffit largement pour tester, ce qui réduit le coût d'expérimentation à presque rien.
Le tableau comparatif qui vous dit quand basculer
Pour décider si Jev a sa place dans votre stack, posez-vous quatre questions.
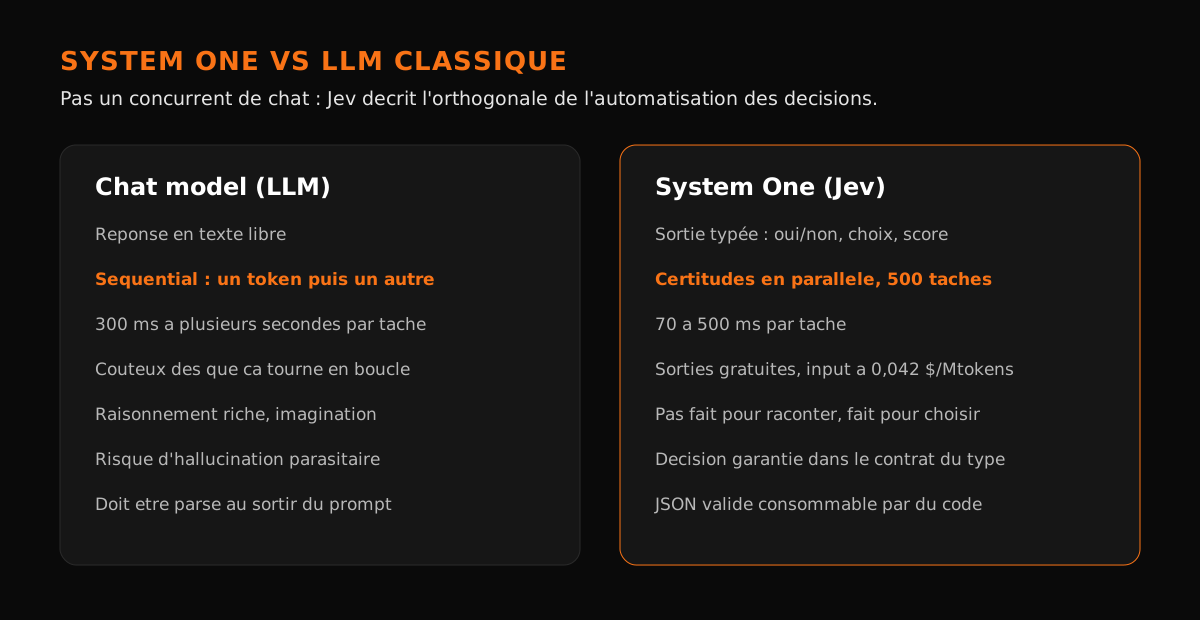
Basculez sur Jev quand la tâche est une décision répétée, le nombre de résultats possibles est fini et connu, le volume est élevé, la latence compte, et un raisonnement long n'est pas requis. Filtrage, triage, scoring, routing, préqualification : tout le haut du tableau.
Gardez un LLM classique quand il faut générer du texte, raisonner en profondeur, écrire du code, composer un email, analyser une image ou produire un long rapport. Jev ne remplace pas votre modèle de langage : il s'installe à côté, sur la couche des décisions.
Le cas mixte est le cas réel. Vous routez avec une System One, vous rédigez la réponse avec un LLM, et vous ne faites remonter à l'humain que les cas sous le seuil de confiance. C'est l'architecture que je mets en place en ce moment chez mes clients, et c'est celle qui coûte le moins tout en gardant un niveau de contrôle maximal.
Un dernier réflexe à garder : commencez par vectoriser votre règle, pas par brancher un modèle sur un modèle. Décrivez la décision comme vous l'expliqueriez à un assistant : les cas, les responsabilités, les seuils. Le formulaire du kit est exactement ce fichier de règles, et c'est lui qui fait la qualité, bien plus que le choix du modèle.
Le piège à éviter avec Jev
Le premier échec avec ces modèles n'est presque jamais dû au modèle. Il est dû au schéma. Si votre formulaire autorise deux options qui se recouvrent, que vos niveaux de score se mélangent, ou que votre échelle n'est pas écrite en clair, Jev répond vite et avec aplomb dans la mauvaise direction. Le type-safe garantit la forme, pas le fond.
Trois règles concrètes :
- Décrivez chaque option par ses responsabilités, pas par une étiquette. Un formulaire qui dit « de quoi il s'agit » est moins bon qu'un formulaire qui dit « qui la traite et pourquoi ».
- Forcez une option de secours. « Autre » est obligatoire dès que votre liste n'est pas exhaustive, sinon le modèle choisira la moins mauvaise option au lieu de signaler qu'il ne sait pas.
- Écrivez l'échelle en toutes lettres. « De 1 à 5 » sans définition, c'est un chiffre vague. « 5 : réponse immédiate exigée, incident client » fait une vraie décision.
FAQ
Combien coûte réellement Jev ?
L'entrée est facturée 0,042 dollar par million de tokens pour les modèles les plus chers de la gamme, et les sorties sont gratuites. Traiter mille emails de classification revient à quelques centimes, et un lot de 20 emails mesuré dans le kit coûte 0,00223 dollar. Le dry-run du kit ne coûte rien, et Vercel propose un niveau gratuit suffisant pour tester.
Jev remplace-t-il un ChatGPT ou un Claude ?
Non. Jev ne génère pas de texte : il rend des décisions typées (oui/non, choix, score) avec une confiance calibrée. Un LLM classique écrit, raisonne et génère, mais il est lent et cher pour les décisions répétées. L'usage type est un pipeline hybride : Jev décide, le LLM rédige, l'humain valide les cas limites.
Pourquoi Jev ne peut-il pas halluciner ?
Parce que sa sortie est contrainte par le contrat du type : le vocabulaire et le schéma sont fixes, la génération de texte libre est bloquée. Le résultat est donc valide par construction. En revanche, une sortie valide peut être erronée sur le fond, d'où les seuils de confiance et la relecture des cas sous 70 à 75 %.
Jev traite-t-il les images ?
Non, Jev est conçu pour le texte et les données structurées. Pour une image, il faut une étape de vision (OCR, description, transcription) réalisée par un autre modèle, puis passer le résultat à Jev. C'est ce pipeline hybride qui a permis d'analyser 27 minutes de vidéo en environ une minute et demie.
Où tourne le modèle et comment l'intégrer ?
Le endpoint décisions d'OpenRouter accepte les appels avec le modèle typesafe/jev, et TypeSafe expose une API dédiée ainsi qu'une console de test. Le kit fourni avec cet article contient le runner complet, les cinq formulaires de décision et la procédure d'installation pour Claude Code et Codex : téléchargez le zip, copiez le dossier, lancez le dry-run, puis le batch.
Un dernier mot
Jev n'est pas le remplaçant de vos modèles de langage. C'est une nouvelle couche dans la pile, celle des décisions rapides et répétées, et elle rend obsolète une bonne partie de l'infrastructure qu'on construisait pour les imiter.
L'avantage le plus rentable est devant vous : prenez un flux que vous traitez à la main ou avec un LLM séquentiel trop cher, écrivez la règle en formule JSON, lancez le dry-run, mesurez. En une heure, vous saurez si Jev est fait pour votre cas. Le kit téléchargeable plus haut vous donne exactement ce qu'il faut pour ce test.
Et si vous voulez que je pose un regard extérieur sur l'automatisation de votre prospection, votre support ou votre qualification de leads, mon audit IA est gratuit et dure quarante-cinq minutes. On prendra un de vos flux réels, on le passera dans ce pipeline, et vous repartirez avec un plan d'implémentation concret.
Un terme IA croisé dans cet article ?
Définitions claires, sans jargon, pour dirigeants de PME.
Kit Jev (zip, 16 fichiers)
Skill, formulaires de décision, runner et exemples prêts à l'emploi pour Claude Code et Codex.
Vous préférez un échange direct avec un expert ? Réservez votre Audit IA Express offert (45 min) →
Relevé hebdomadaire des Agents & Automatisations IA
Chaque samedi matin, recevez notre sélection d'articles, retours d'expérience terrain et cas d'usage concrets sur les Agents IA en PME. Synthèse directe, zéro superflu.
Direction IA Externalisée en région