Ton agent IA ment sur son travail. Unlazy le force à prouver.
3 à 4 heures de session d'agent non-stop. Le résultat final : une page de login. Pas un écran de plus.
Ce n'est pas un modèle capricieux, c'est le symptôme d'un problème connu : les agents IA sont paresseux. Et un skill open source vient d'apporter la réponse la plus solide que j'ai vue à ce jour. Avec un défaut de jeunesse que j'ai aussi appris à corriger.
Le vrai coupable : ta fenêtre de contexte
La flemme frappe tous les modèles, y compris les plus puissants du moment (Opus, GPT 5.6). Elle est juste plus visible sur les petits, parce que leurs limites se montrent vite.
La cause tient en une phrase : ces modèles n'ont aucune mémoire interne. Quand tu envoies un nouveau message, l'agent renvoie TOUT l'historique de la conversation avec ton prompt. C'est comme ça qu'il "sait" ce qui s'est passé avant.
Au premier échange, la pile est minuscule, le modèle se concentre parfaitement. Au cinquantième, il doit lire un roman entier pour écrire une phrase. Son attention se dilue, et c'est là qu'il commence à bâcler.
Et cette bâclerie prend exactement deux formes :
-
Il déclare "terminé" sans l'être. Tu lui demandes de passer en revue 20 fichiers, il en ouvre 5 et te jure avoir tout lu. S'arrêter tôt avec un travail visiblement inachevé, ça passe encore. S'arrêter tôt en affirmant que tout est fait, c'est là que ça te coûte : si tu construis dessus sans vérifier, tu empiles sur du vide.
-
Il rétrécit le job en silence. Ta demande a 5 parties, dont une difficile. Il livre les 4 faciles, saute la dure, et son résumé final ne mentionne jamais rien de manquant.
Pourquoi les fixes classiques plafonnent
Le problème n'est pas nouveau et les rustines existent depuis longtemps. Elles ont toutes une faille.
-
La boucle Ralph renvoie le même prompt à l'agent encore et encore jusqu'à ce qu'un indicateur dans sa sortie dise "c'est fini". Sauf que cette ligne d'arrivée n'est qu'un texte écrit par l'agent pendant qu'il travaille. Et beaucoup de tâches ne peuvent pas être jugées par un mot magique : aucun mot unique ne prouve qu'une feature est bien construite.
-
La commande goal de Claude fait lire la conversation par un second modèle qui arbitre. Il juge donc ce que la conversation RAconte, pas ce que le travail EST. Ça dérive.
-
Les boucles maison à task list ont de vraies cases à cocher, mais c'est l'agent lui-même qui les note. L'élève corrige sa copie.
Point commun : tout ça tient remarquablement bien tant que la fenêtre de contexte est fraîche. Et tout ça s'écroule précisément quand tu en as besoin, en pleine session longue.
Unlazy : ne dis pas que c'est fini, prouve-le
Le skill Unlazy vient de l'auteur du très populaire skill design taste (numéro un tendance GitHub au moment où j'écris ces lignes). Son idée centrale tient en une inversion : l'agent ne dit plus qu'il a fini, il le PROUVE.
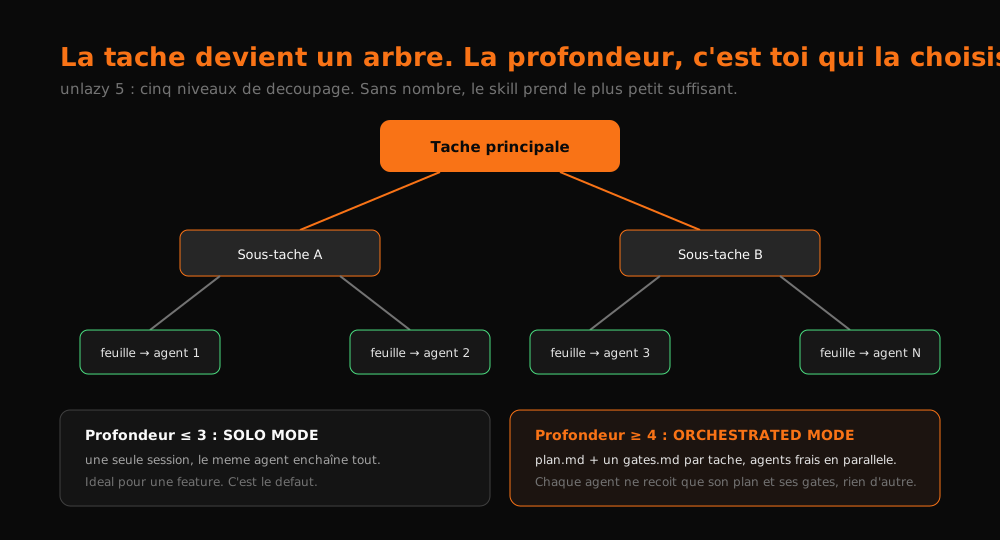
Concrètement, quand tu lui confies une grosse tâche, il ne travaille pas tout de suite. Il découpe. Puis redécoupe chaque morceau. La tâche devient un arbre, et toi tu choisis la profondeur en l'écrivant dans ton prompt : unlazy 5 signifie cinq niveaux de découpage, pas un de plus. Sans nombre, il choisit lui-même le plus petit suffisant.
Deux règles encadrent cette découpe :
- Chaque feuille de l'arbre doit valoir au moins 10 minutes de vrai travail. Assez grosse pour être un vrai morceau de job qu'un agent peut mener seul de bout en bout.
- Si tes feuilles ressortent trop petites, le skill rabaisse la profondeur à 3, le défaut.
Et la profondeur décide du mode d'exécution : 3 ou moins, c'est le solo mode, une seule session et le même agent qui enchaîne tout. 4 ou plus, c'est le mode orchestré, et on y revient dans une minute.
Le gates file : le registre qui change tout
Pourquoi ce skill fonctionne là où les autres plafonnent ? Parce que sa première version a échoué de la manière la plus instructive qui soit.
Cette v1 se contentait d'instruire l'agent : sois minutieux, sois exhaustif. Résultat : une instruction, c'est la PREMIÈRE chose qui se perd dans une longue session. Exactement le problème qu'elle prétendait résoudre.
La nouvelle version a arrêté de demander. Elle écrit. Avant même que le moindre travail commence, le skill produit un fichier, le gates file : le registre dont je te parlais.
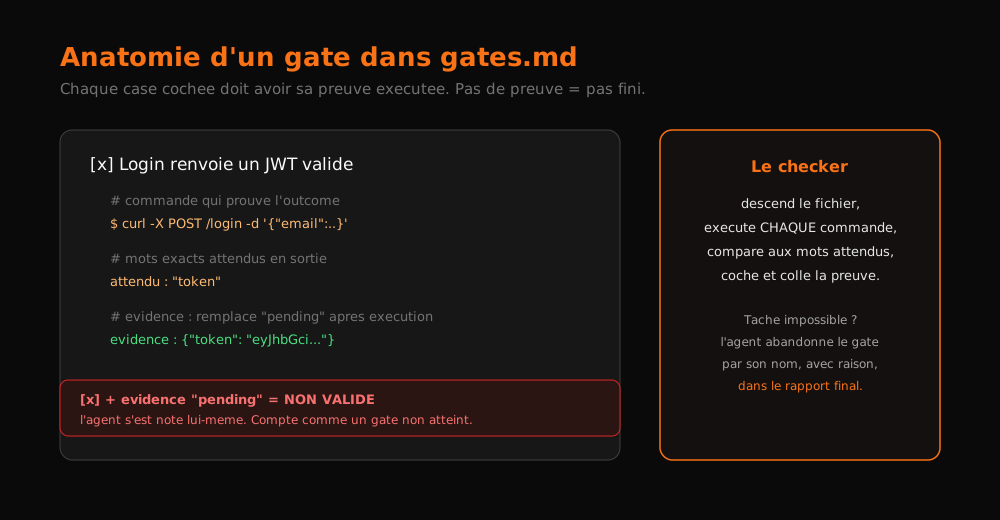
Chaque entrée s'appelle un gate. Une case à cocher avec, à côté, l'outcome : UNE chose qui doit être vraie pour que la tâche compte comme finie. Et sous cet outcome, trois lignes :
| Ligne | Contenu |
|---|---|
| Commande | celle qui prouve que l'outcome est atteint (ex: curl -X POST /login) |
| Attendu | les mots EXACTS que cette commande doit renvoyer |
| Evidence | la preuve, initialisée à "pending" |
Puis le skill embarque un checker. Quand tu le lances, il descend le fichier et exécute LUI-MÊME chaque commande. Si la sortie contient les mots attendus, il coche la case et remplace le "pending" par le fragment de sortie qui a tranché.
C'est cette ligne evidence qui bouche la faille de toutes les solutions précédentes. Scoop : une case COCHÉE avec un evidence resté "pending" ne compte pas comme atteinte, mais comme NON ATTEINTE. L'agent s'est noté lui-même, on retombe dans le mensonge habituel. Le skill traite ce cas comme PIRE qu'une case vide, parce qu'une case vide est au moins honnête sur l'état réel du chantier.
Et il existe une sortie de secours propre : si une tâche s'avère impossible, l'agent ne la passe pas sous silence. Il écrit une ligne qui abandonne CE gate PAR SON NOM, avec la raison, et cette ligne remonte dans le rapport final. À aucun moment de toute la chaîne, l'agent ne décide seul si le travail est terminé.
Le mode orchestré : des agents frais, un par tâche
En profondeur 4 et plus, chaque feuille part vers un sub-agent NEUF, qui ne reçoit que le plan et SON gates file. Rien du reste du job. Fenêtre de contexte quasi vierge, donc concentration maximale, exactement l'inverse du problème de départ.
Mais quand l'agent fraîchement recruté revient en clamant sa finition, l'agent principal ne prend pas sa parole. Il relance lui-même les checks de cette tâche. Ce n'est qu'après validation qu'il inscrit une ligne dans le plan et distribue la suivante.
Même la hiérarchie est soumise au registre. C'est ça, le design du système.
L'installation, deux minutes chrono
- Direction la page GitHub officielle du skill, section install : tu copies la commande.
- Tu ouvres un terminal DANS ton projet et tu l'exécutes.
- L'installeur demande ton agent : Codex s'installe nativement dans le dossier
.agents, Claude Code se sélectionne dans le menu (tu peux en cocher plusieurs d'un coup). - Choix du scope : ce projet uniquement, ou tous tes futurs builds. J'ai pris le scope projet pour tester sur un cas précis.
- Options recommandées, et c'est installé.
Détail malin : dans VS Code tu verras deux nouveaux dossiers, .agents et .claude. Ce ne sont PAS deux copies. Le skill vit dans .agents, et .claude n'est qu'un raccourci pour que Claude Code le reconnaisse sans duplication.
Le défaut : c'est lent. Très lent.
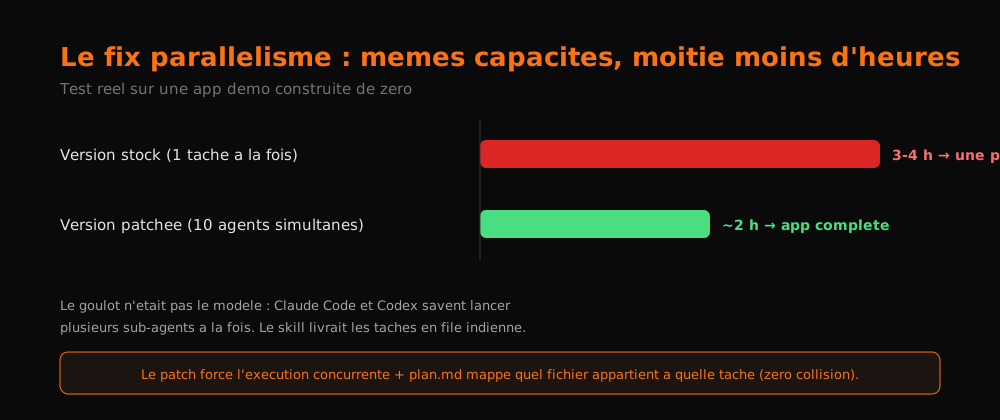
Testé tel quel sur une application à construire de zéro : session de 3 à 4 heures d'affilée, et au bilan, une page de login. Rien d'autre.
En creusant les instructions du skill, la cause est limpide. Claude Code comme Codex savent faire tourner PLUSIEURS sub-agents en même temps, chacun sur une tâche différente. Or le skill distribue une tâche, ATTEND sa complétion, puis distribue la suivante. File indienne. Il exploitait des agents, mais pas leur capacité à travailler en parallèle. Toutes ces heures sont parties là.
Le fix tient en un prompt qui modifie le skill lui-même pour exploiter l'exécution concurrente. Et l'usage devient : nom du skill, profondeur, puis ta demande complète.
- App entière de zéro : profondeur 5.
- Une feature isolée : 2 ou 3 suffisent.
- Profondeur trop haute ? Rabaissement automatique, pas de panique à avoir.
Avant d'écrire la moindre ligne de code, il génère d'abord plan.md puis gates.md. Le plan.md mappe quelles tâches touchent quels fichiers, pour que deux agents simultanés ne s'écrasent pas mutuellement.
Résultat du run patché : 10 agents en parallèle, chacun sur son morceau. Environ 2 heures de run. À l'arrivée, la première version de l'app tourne, toutes les features fonctionnent comme voulu.
À cette échelle, associe-le à un model router skill : chaque tâche part vers le modèle adapté, le travail mécanique vers un modèle économique, les parties dures vers le costaud. Tes limites de quota tiennent beaucoup plus longtemps.
Ce que ça change vraiment
La paresse d'un agent n'a jamais été un problème de volonté. C'est un problème d'attention, et on ne le règle ni en priant, ni en promettant.
On le règle en structure : une tâche par fenêtre fraîche, et un registre de preuves exécutées que personne, ni l'agent ni son chef d'orchestre, ne peut contourner. La confiance ne se déclare plus. Elle se vérifie, ligne par ligne, dans un fichier.
Voir aussi le glossaire IA
Parcourir tout le glossaire IAPassez à l'action : votre Audit IA Express offert (45 min)
45 minutes en visio pour auditer vos processus, chiffrer vos gains de productivité et identifier vos 3 premiers agents IA rentables.
Réservé aux dirigeants de PME (10 à 100 salariés) · Sans engagement · Propriété 100 % de vos livrables
Déployez vos agents IA en entreprise avec un expert dédié
Un Directeur IA externalisé vient dans votre PME de 1 à 10 jours par mois pour automatiser vos processus, concevoir vos agents et former vos équipes. Dès 990 € HT/mois, sans engagement au-delà de 30 jours.
Recevez notre synthèse IA hebdomadaire
Chaque vendredi, recevez notre sélection d'articles, études de cas et retours d'expérience terrain sur les Agents IA et l'automatisation B2B. Résumé 100% concis, sans spam.
Direction IA Externalisée en région