GPT-6 Astra : le modèle qui ne devine plus
On aura eu GPT-6 avant GTA 6. Et ce modèle-là, il a changé ma façon de travailler.
Je l'ai testé toute la journée depuis sa sortie. Pas pour faire des démos 3D spectaculaires, mais pour du vrai : déployer des agents, produire du contenu, vérifier de la donnée. Le constat est brutal. Le saut n'est pas là où tout le monde le regarde.
Ce qui change vraiment : pas l'intelligence, la fiabilité
Regardez comment les benchmarks sont commentés depuis 48 h. Tout le monde parle de "saut quantique" sur les maths, le raisonnement, l'informatique. C'est vrai, les chiffres sont là. Mais le vrai changement, celui qui va décider si cette IA s'installe ou non dans une PME, il est ailleurs.
Astra ne devine pas.
C'est la phrase à retenir de tout cet article. Quand un modèle IA cherche des instructions et qu'il ne les trouve pas, il a deux options. Soit il invente, soit il s'arrête. Tous les modèles qu'on connaissait inventaient. Astra, lui, pause son travail quand il ne peut pas faire le job proprement.
Ça paraît anodin dit comme ça. C'est pourtant un bouleversement complet de la relation de travail.
J'ai passé des années à corriger des agents qui avaient "fait de leur mieux". Ils hallucinaient une donnée, produisaient une interface foireuse, puis me répondaient avec enthousiasme que c'était parfait quand je signalais un problème. Ce boucle-là, celle où l'IA te dit "tu as raison" cinq fois de suite sans jamais se corriger, c'est exactement ce qui détruit la confiance dans l'automatisation.
Astra casse ce schéma. Sur un benchmark d'automatisation réel géré par Zapier, le modèle précédent de chez OpenAI (GPT-5.6 Sol) obtenait des points partiels en devinant. Astra a abandonné la tâche parce qu'il ne trouvait pas l'instruction. Et c'est un bon résultat, pas un échec. Parce que le jour où tu automatises un process métier, tu préfères très largement un agent qui te dit "je bloque, il me manque une info" plutôt qu'un agent qui fabrique un chiffre faux et le présente avec assurance.
Scoop : le comportement exactement inverse de tout ce qu'on acceptait jusqu'ici.
Ce que j'ai vérifié moi-même, sur du concret
J'aime bien confronter un modèle au même brief, dans les mêmes conditions, sans retoucher. J'ai lancé deux builds sur GPT-6 Astra et sur son prédécesseur GPT-5.6 Sol : un système solaire interactif dans une page HTML autonome, puis une maison 3D où on peut changer la lumière, le toit et les matériaux.
Astra a mis environ deux fois plus de temps et coûté trois fois plus cher. Et visuellement, il n'y a pas photo. Le système solaire était plus propre, plus travaillé, plus vivant. La maison était réellement manipulable : on changeait la façade, on passait en mode crépuscule, on retirait le toit, on lisait la surface habitable, les chambres, la terrasse. Le résultat de Sol, lui, était joli sans avoir vraiment de sens à l'intérieur. Même moi, sur un brief de ce niveau, j'ai été surpris qu'un modèle rate la première version autant.
Ce qui m'a le plus impressionné, ce n'est même pas le résultat. C'est la façon de travailler. Astra est capable de reprendre ses propres prototypes, de repérer un problème, de le corriger, de juger si c'est réglé, puis d'avancer. Il gère lui-même ses boucles d'amélioration au lieu que ce soit toi qui boucle à sa place.
La boucle d'auto-vérification
Le second changement est dans la continuité. Astra ne produit pas et passe à la suite. Il vérifie.
Concrètement, quand il développe, il ouvre lui-même un navigateur pour tester ses features. Il clique sur les boutons qu'un utilisateur cliquerait. Il inspecte la console, cherche les erreurs, détecte des conditions de course, recharge la page. Ce travail de QA, que les équipes faisaient manuellement à chaque livraison, il se le fait en interne avant de te rendre le résultat.
Un développeur l'a décrit avec des mots simples : c'est le meilleur modèle "one shot" qu'il ait jamais vu. Le one shot, c'est donner une instruction une seule fois et obtenir un résultat fini, sans itération ni correction de ta part. Pendant des années, ça relevait du mythe. Astra le fait à répétition parce qu'il s'auto-corrige avec le computer use.
Résultat : pour la première fois, un modèle peut non seulement produire, mais contrôler sa propre production. Et quand il contrôle sa production, il peut l'améliorer en boucle sans qu'un humain passe derrière.
Les chiffres, et surtout le prix par résultat
Allez, parlons chiffres. Parce qu'ici aussi, il y a un piège de lecture.
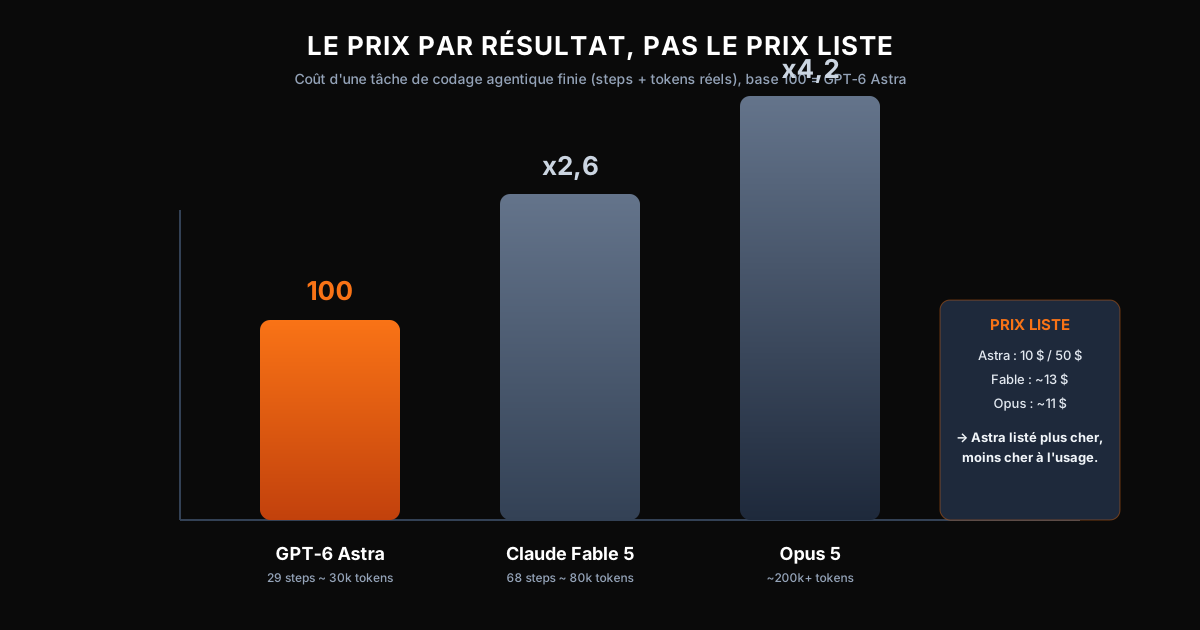
GPT-6 Astra coûte officiellement 10 dollars par million de tokens en entrée et 50 dollars en sortie. C'est 2,5 fois plus cher que GPT-5.6 Sol (4 $ / 20 $). Sur le papier, ça choque. Dans la vraie vie, la facture finale raconte une autre histoire.
| Modèle | Prix liste | Steps (Terminal Bench) | Output tokens | Temps/tâche | Verdict |
|---|---|---|---|---|---|
| GPT-6 Astra | 10 $/50 $ | 29 | ~30 000 | ~4 min | Il optimise |
| Claude Fable 5 | ~13 $ | 68 | ~80 000 | ~9,5 min | 2x plus de travail pour moitié moins de rendement |
| Opus 5 | ~11 $ | très élevé | ~200 000+ | lent | Gaspille les tokens |
Sur le benchmark de codage agentique, Astra fait une tâche en 29 steps là où Fable en mettait 68. Presque trois fois moins de tokens de sortie pour un résultat comparable. Le temps moyen par tâche passe de 9,5 minutes à 4 minutes. Astra consomme en moyenne 10 fois moins de tokens que Fable et 42 fois moins qu'Opus 5.
En clair : le prix liste est plus élevé, mais le prix par résultat est plus bas. Et c'est la seule mesure qui compte quand on automatise un process.
``` Règle à retenir : ne regarde jamais le prix liste d'un modèle. Regarde le prix par tâche finie. ```
Regardons quelques benchmarks bien précis, parce qu'ils racontent les vraies forces.
| Benchmark | Astra | Voici ce que ça veut dire |
|---|---|---|
| Maths difficiles | 97,6 | Sol était à 83. Grosse marche. |
| Automation Bench (tâches pro) | 41,4 | Sol à 18,1. Le double, sur du concret. |
| Terminal Bench | 58 % | Premier, à moitié prix de Fable. |
| ARC (raisonnement) | ~100 % | "C'est fini", disent les testeurs. |
| Agent Last Exam | 7,28 $ | Fable coûtait 28 $ pour le même test. |
Deux réserves honnêtes avant qu'on continue. OpenAI lui-même a évoqué une possible intoxication aux réponses de benchmarks. Les scores sont une direction, pas une vérité absolue. Et dans cet écosystème, rien ne tient plus de 48 h : Fable 5.1 était le meilleur modèle du monde il y a trois jours, Astra l'a détrôné le lendemain. La course est folle, et c'est exactement pour ça qu'il faut raisonner en prix par résultat plutôt qu'en fan club.
Ce que ça permet concrètement : vingt usages réels
La vraie matière, ce sont les cas d'usage. J'ai recensé une vingtaine d'exemples documentés, testés par des gens sérieux, tous reproductibles. Je les ai classés non pas par effet "wow", mais par métier, parce que c'est comme ça que tu vas les utiliser.
Pour le marketing et le contenu
- La vidéo éducative propre. Un prompt unique a produit une vidéo pédagogique de 5 minutes, sans artefact visible, sans ce rendu "IA évident" qui tue la crédibilité. C'est le seuil qui rend un contenu publiable tel quel. Utile pour des formations, des explications produit, des séquences de démonstration.
- L'écriture. Des gens très exigeants sur le style (des auteurs quotidiens) le décrivent comme le meilleur modèle d'écriture jamais testé : rapide, peu de remplissage, et surtout facile à diriger. Il suit la consigne. Il n'écrit pas "son truc" en ignorant la tienne. Si tu produis des emails, des propositions, des articles, c'est LA qualité qui compte.
- Les présentations. Basé sur un fichier de référence, il reproduit une présentation presque identique. Dans PowerPoint, il devient un assistant qui respecte ta charte visuelle. Si ton équipe passe des heures sur des slides, tu sais ce que ça vaut.
Pour l'admin, la finance et la vérification
- L'audit de documents. Sur un test avec 41 documents financiers et des erreurs volontairement dissimulées, il a retrouvé les 4 erreurs. Le fournisseur des comptes annonçait 40 % de progrès sur ce test spécifique. Sur un corpus de 10 modèles financiers, il a coordonné 55 sous-agents pour tout vérifier et corriger.
- Le contrôle de conformité. Sur la relecture d'un NDA face à la politique contractuelle de l'entreprise, le score passe de 69 % à 93 %. Et surtout, il cite la clause exacte qui justifie sa décision. Il ne dit pas juste "non conforme", il montre pourquoi, avec la référence précise.
- L'extraction depuis tes données. Connecté à une boîte mail, il a recherché toutes les factures d'équipement acheté dans le temps et les a comparées aux prix actuels du marché. Le pattern vaut de l'or : extraire une connaissance de ta data interne, puis la confronter au réel. Combien de choses dorment dans tes emails, tes fichiers, ton historique ?
Pour la qualité, le support et les outils internes
- Le QA automatisé. Un test de contrôle qualité sur un navigateur a tourné plus d'une heure, cliquant sur chaque bouton, testant chaque parcours utilisateur, inspectant la console pour les erreurs, cherchant les conditions de course. Un humain n'aurait jamais fait ça avec cette régularité, et surtout il n'aurait pas documenté chaque étape.
- Le montage vidéo. Sur Final Cut Pro, il a importé les fichiers, fait l'étalonnage, synchronisé les plans multicaméras, et même repéré la meilleure piste audio parmi plusieurs, en supprimant les autres. Des tâches répétitives que des équipes font à la main chaque semaine.
- Les applications métier sur mesure. Une appli scientifique qui mesure des données d'immunologie, que des labos payaient des milliers ou des dizaines de milliers de dollars en abonnement : une version utilisable est née d'une série de demandes. Le pattern vaut pour n'importe quel outil métier spécifique à ta boîte.
Le spectacle (parce que ça compte aussi)
Il serait malhonnête de ne pas mentionner ce qui a fait le tour du web. Un monde entier avec 600 personnages autonomes qui se parlent, planifient, survivent. Une ville type Sim City entièrement jouable avec gestion des urgences. Un tableau de Van Gogh transformé en monde 3D qu'on traverse. La reconstruction d'un monument de San Francisco dans Blender avec le bon nombre de doigts. Une interface "Minority Report" pilotée à la main pour contrôler un Mac. Et un record : Pokémon terminé en 18 heures, quand un humain met 25 à 35 heures. C'est la première fois qu'une IA boucle un jeu plus vite qu'un joueur humain.
Ces démos sont spectaculaires et largement inutiles au quotidien pour une PME. Mais elles disent une chose : le plafond est beaucoup plus haut que ce qu'on croyait. Ce qui était un "proof of concept" bancal il y a six mois est devenu un produit fini. Chaque fois que ce seuil se franchit, des usages concrets émergent dans les semaines qui suivent.
Les limites, et pourquoi elles me rassurent
Un bon test, c'est aussi un test raté. Astra a des trous. Il a produit un clone de Gmail franchement laid (0/10 pour les testeurs). Il loupe certaines landing pages quand on attend une reproduction fidèle. Sur le frontend pur, Gemini reste meilleur. Sur le coding agent index agrégé, Opus reste devant. Et les projets longs (un wiki personnel construit sur 5 jours, ~5 000 $ de tokens estimés) demandent un budget qu'une PME ne mettra pas comme ça.
Ces limites ne sont pas un problème. Elles sont même une bonne nouvelle. Un modèle qui réussit tout tout le temps, c'est un modèle qu'on ne peut pas critiquer et donc pas vraiment circonscrire. Astra, lui, a un périmètre clair : il excelle quand il y a une instruction à appliquer, une vérification à faire, un process à tenir. C'est exactement le terrain des agents métiers.
Oui, mais c'est cher, et qui y a accès ?
Deux objections que tu te poses sûrement. Le prix d'abord : 10 $ le million de tokens en entrée, 50 $ en sortie. Le modèle précédent était à 4 $ / 20 $. Sur l'abonnement mensuel, ça se traduit beaucoup plus gentiment que ce que je viens d'écrire, parce que la facture dépend aussi du nombre d'itérations et du niveau de raisonnement. Bien dosé, un projet entier passe pour quelques dizaines de dollars. La vraie mauvaise affaire, ce n'est pas Astra qui est cher, c'est de payer un modèle cher pour un résultat qu'un petit modèle donnerait aussi bien.
Ensuite, qui y a accès : les plans ChatGPT Plus, Pro, Business et Enterprise, ainsi que la plateforme API et les outils de développement comme Codex et Work. Le ChatGPT gratuit n'y a pas droit. C'est le fonctionnement normal des modèles frontières : on ne met pas un moteur de cette facture devant un million d'utilisateurs gratuits. Pour une PME, le chemin est simple : abonnement Pro ou Business pour les équipes, API pour les process automatisés.
Une mention qui mérite son paragraphe : la cybersécurité. Astra est le premier modèle à atteindre le seuil "critical" dans les évaluations de sécurité. Avec les bons outils, il est capable de trouver des failles inconnues (des vulnérabilités zéro-day) et de développer une exploitation sans guidage humain à chaque étape. Ça demande des heures et des conditions très spécifiques (29 h pour pénétrer un navigateur, en mode ultra). Pour toi, l'info utile est ailleurs : OpenAI le présente aussi comme le modèle le plus aligné jamais sorti, celui qui respecte le mieux les limites qu'on lui fixe. Alignement élevé et capacité hors norme, c'est justement pourquoi les accès publics sont bridés par rapport aux capacités internes. C'est normal, et c'est plutôt rassurant.
Les six conseils pour en tirer le maximum
- Montre-lui le résultat attendu. Plutôt que de décrire ce que tu veux, donne-lui un exemple, un fichier de référence, une image du rendu. Il est excellent pour rétro-ingénierer une cible. Tu seras surpris du premier jet.
- Force-le à poser des questions avant de coder. Dis-lui explicitement de clarifier ce qui n'est pas défini avant de commencer. C'est une discipline qui transforme ses outputs.
- Demande une page de vérification. Pour du visuel ou de l'architecture, demande-lui de produire d'abord une page HTML qui montre le rendu prévu, avant de tout construire. Tu valides la direction sans gaspiller des tokens.
- Dose le niveau de raisonnement. Le niveau low suffit sur énormément de tâches. Le medium donne ce qu'on obtenait en effort max sur le modèle précédent. Le high est pour les problèmes durs. Le max, c'est du luxe pour les cas critiques.
- En computer use, commence léger. Il prend le contrôle de ton ordinateur et il est étonnamment bon à ça depuis le premier essai. Réserve le mode ultra (sous-agents parallèles) aux gros projets, et utilise la fonction "goal" pour les tâches longues. Bonus : il pose des questions en cours de route et tu peux réorienter le travail sans tout relancer.
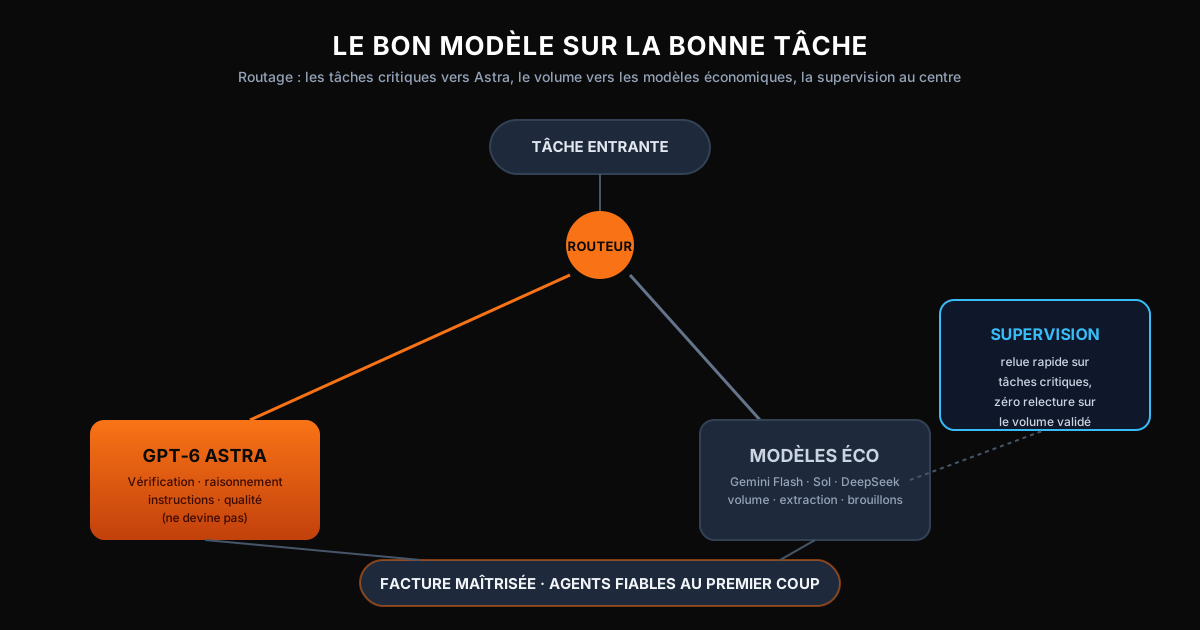
- Ne l'utilise pas pour tout. C'est le piège classique. Sur du volume, un modèle économique (Gemini Flash, GPT-5.6 Sol, DeepSeek) fera le travail à une fraction du coût. On ne prend pas un avion de chasse pour aller acheter du pain. L'architecte, c'est toi : tu routes les tâches dures vers Astra, le reste vers les modèles pas chers, et la facture est maîtrisée.
La preuve la plus parlante : il a mené sa propre campagne de lancement
L'exemple le plus frappant du repositionnement humain/IA, celui qui devrait faire réfléchir chaque dirigeant, c'est celui qu'a documenté l'équipe qui a lancé le modèle.
Pour conduire la campagne de lancement de GPT-6 Astra, ils ont utilisé GPT-6 Astra. La liste des tâches qu'il a portées ressemble à un poste complet : construire et tenir à jour les fichiers Google Sheets, créer et mettre à jour le plan de communication au fil de l'avancement, rédiger les messages aux journalistes, gérer les embargos, suivre les réponses, préparer les briefings presse, créer les PDF liés aux articles de blog, collecter les assets des équipes et construire les kits de presse, suivre la couverture du modèle en temps réel sur tout le web, et produire un rapport de synthèse de tout ça.
L'humain, dans cette histoire, a fait quoi ? Il a animé les appels, porté le récit global et la stratégie, pris les décisions, surveillé la situation et dormi une nuit complète.
C'est la meilleure illustration de ce que je te dis depuis le début de l'article : la frontière s'est déplacée. Les tâches de volume, de tenue à jour, de suivi, de production récurrente sont désormais le travail de la machine. L'humain garde la stratégie, la communication, la décision. Et ce n'est pas un concept, c'est un exemple réel, récent, chiffré.
Autre signal dans le même sens : pour tracer ses propres coûts à l'usage, un utilisateur lourd a fait construire par Astra une application qui agrège la consommation de tous ses modèles et abonnements (une petite interface style macOS, générée en un seul passage, qui montre les tokens dépensés, les modèles les plus utilisés, les factures par période). Il voulait voir où partait son argent. Même logique que dans la PME : ce qu'on ne mesure pas explose. Une fois qu'un outil te dit combien coûte réellement chaque modèle sur tes vraies tâches, tu arrêtes de raisonner en prix théorique et tu raisonnes en prix réel. C'est exactement le réflexe de routage que je recommandais plus haut.
Ce que ça change pour une PME
Voilà où je veux en venir. Parce que ce modèle ne va pas finir dans des démos YouTube, il va finir dans des process.
Pendant des années, la limite de l'automatisation n'était pas l'intelligence. C'était la surveillance. Un agent produisait, un humain vérifiait, corrigeait, revalidait. Ce coût de supervision doublait ou triplait l'économie réelle d'un process automatisé.
Astra déplace cette ligne. Quand le modèle vérifie sa propre production, ouvre un navigateur pour tester, s'arrête au lieu d'inventer, la supervision humaine se réduit drastiquement. Tu peux confier un process réel à un agent sans avoir un humain qui passe derrière à chaque sortie. C'est ça, le vrai saut pour une entreprise : pas des agents plus intelligents, des agents plus autonomes sans être plus risqués.
Deux garde-fous tout de même. Les comptes et les données restent à ton nom, dans ton environnement. Et sur les tâches critiques (argent, conformité, client), la supervision reste, mais elle devient une relecture rapide au lieu d'un contrôle de fabrication.
Concrètement, je déploie aujourd'hui des agents qui font ce qu'on n'osait pas leur confier il y a six mois : répondre à des prospects avec fiabilité, contrôler des fichiers financiers, produire du contenu publiable sans relecture exhaustive, tester tes propres outils avant mise en prod.
Le modèle qui ne devine plus
On a passé des années à accepter une IA qui bricolait et qu'on corrigeait. Astra est le premier modèle de cette génération qui tient la promesse inverse : il ne devine pas, il vérifie, il s'arrête quand il faut, et il coûte moins cher par résultat malgré un prix affiché plus élevé.
L'expertise n'est plus de choisir le meilleur modèle. Elle est de savoir quelle tâche confier à quel modèle, et comment cadrer le travail pour qu'il soit fiable du premier coup.
C'est exactement le métier que je fais : quand tu me confies ton automatisation, je ne te vends pas un modèle, je construis le routage, les garde-fous et les process qui font qu'un agent peut tourner sans qu'un humain passe derrière. Et je commence toujours par un audit gratuit de 45 minutes pour voir où l'automatisation peut te faire gagner du temps, avant de dépenser le moindre euro.
Si tu veux savoir ce que ça donnerait dans ton entreprise, on regarde ça ensemble.
Voir aussi le glossaire IA
Parcourir tout le glossaire IAPassez à l'action : votre Audit IA Express offert (45 min)
45 minutes en visio pour auditer vos processus, chiffrer vos gains de productivité et identifier vos 3 premiers agents IA rentables.
Réservé aux dirigeants de PME (10 à 100 salariés) · Sans engagement · Propriété 100 % de vos livrables
Déployez vos agents IA en entreprise avec un expert dédié
Un Directeur IA externalisé vient dans votre PME de 1 à 10 jours par mois pour automatiser vos processus, concevoir vos agents et former vos équipes. Dès 990 € HT/mois, sans engagement au-delà de 30 jours.
Recevez notre synthèse IA hebdomadaire
Chaque vendredi, recevez notre sélection d'articles, études de cas et retours d'expérience terrain sur les Agents IA et l'automatisation B2B. Résumé 100% concis, sans spam.
Direction IA Externalisée en région