Accueil / Blog / Agents & Automatisation
Un agent IA local qui vous parle, code et travaille seul
 Gary Bramnik
7 septembre 2026 · 9 min de lecture
Sommaire
- Hermes, l'agent qui vit chez vous, pas chez OpenAI
- Installer Hermes en cinq minutes
- Le vrai twist : lui faire construire sa propre interface
- Donner une vraie voix à l'agent (et le faire taire quand il faut)
- Le panneau de contrôle : voir ce que l'agent fait sans avoir à le lire
- La preuve : une journée de recherche en vingt minutes
- Pourquoi c'est un produit, pas juste un bricolage du dimanche
- Ce que ça change vraiment
- FAQ : installation et fonctionnement d'Hermes
- Ce que je construis avec ça en Direction IA Externalisée
Il est 7h du matin. Mon agent IA tourne depuis deux heures déjà.
Pendant que je prenais mon café, il a scanné dix chaînes YouTube du secteur IA et automatisation, extrait trente-quatre transcripts, et rédigé un rapport de plusieurs pages sur ce qui fait qu'un contenu marche. En parallèle, dans un autre onglet, il finissait un petit jeu façon Space Invaders que je lui avais commandé pour tester le multitâche.
Je n'ai rien tapé. Je lui ai juste parlé.
Ça tourne sur mon propre ordinateur, gratuitement, sans dépendre du cloud de quelqu'un d'autre. Voici comment je l'ai construit, étape par étape, et pourquoi c'est exactement le genre de système qu'une agence facture à cinq chiffres pour installer.
Hermes, l'agent qui vit chez vous, pas chez OpenAI
Le moteur derrière tout ça s'appelle Hermes Agent. C'est un projet open source sous licence MIT, publié par Nous Research, qui tourne en local sur votre machine. Pas sur un serveur tiers, pas dans un abonnement SaaS.
La différence avec un chatbot classique tient en un mot : il agit. Un chat répond à une question. Hermes cherche sur le web, pilote un navigateur, écrit et exécute du code, ouvre et modifie vos fichiers, et peut faire tout ça seul, sur un planning automatisé (cron), pendant que vous êtes ailleurs. Une veille concurrentielle chaque matin, une sauvegarde chaque nuit, un rapport qui vous attend au réveil.
Il garde aussi de la mémoire d'une session à l'autre, apprend de nouvelles compétences avec l'usage, et se connecte là où vous êtes déjà : Telegram, WhatsApp, Slack, email.
Le hic : par défaut, on lui parle en tapant dans un terminal ou dans une conversation texte. C'est très bien jusqu'à ce qu'on imagine l'alternative. Lui parler à voix haute, l'entendre répondre avec une vraie voix, et voir tourner ses tâches sur un écran devant soi.
C'est exactement ce que j'ai construit ensuite : un tableau de bord de commandement vocal.
Installer Hermes en cinq minutes
Côté installation, sur macOS, Windows ou Linux via WSL2, une seule commande dans le terminal télécharge et installe toutes les dépendances. Le site officiel (hermes-agent.nousresearch.com) propose aussi une application desktop en un clic si vous préférez éviter le terminal.
À la première ouverture, deux options apparaissent :
- Setup rapide : vous utilisez les fournisseurs IA intégrés de Nous Research, clé en main.
- Setup complet : vous branchez vos propres clés API et choisissez votre fournisseur (OpenAI, OpenRouter, xAI Grok, et une dizaine d'autres).
Le choix qui change tout se joue au moment de configurer le fournisseur. Plutôt que de payer l'API OpenAI au token, on peut s'authentifier via OpenAI Codex avec le compte ChatGPT qu'on paie déjà. Résultat : plusieurs semaines d'usage intensif sur GPT-5.5 sans jamais toucher aux quotas, sans un euro de facture API en plus.
Une fois connecté, on choisit un canal de messagerie si on veut (Telegram, par exemple, ou on saute l'étape si on prévoit de construire une interface dédiée), on active les outils dont on a besoin (Firecrawl pour le scraping web, génération et analyse d'image), et Hermes est prêt. Un simple hermes dans le terminal ouvre le chat.
Le vrai twist : lui faire construire sa propre interface
C'est là que ça devient intéressant. Plutôt que de coder un tableau de bord à la main, j'ai collé à l'agent un seul prompt (fourni dans la documentation du projet) qui décrit ce que je veux : une interface locale au look poste de commandement, branchée sur le serveur d'Hermes, avec entrée et sortie vocale, des boutons de commandes rapides, un système d'approbation, et un panneau de contrôle de mission.
Huit minutes plus tard, la première version tournait. Un redémarrage du serveur pour prendre en compte les nouveaux fichiers, et l'interface s'affichait dans le navigateur.
Ce n'était pas parfait du premier coup. Un espacement de travers, un bouton mal placé. La correction ne demande aucune ligne de code : on retourne dans le chat et on décrit ce qui cloche. "Le panneau est trop grand", "ce bouton ne répond pas". L'agent relit ses propres fichiers, corrige, et recharge la page tout seul.
Le métier a changé de nature. On ne code plus l'outil, on le décrit et on le corrige.
Donner une vraie voix à l'agent (et le faire taire quand il faut)
Sans configuration supplémentaire, la synthèse vocale passe par le navigateur : une voix robotique correcte, mais sans plus. Pour une vraie voix, il faut brancher ElevenLabs.
Le plan gratuit suffit pour démarrer, mais les quotas sautent vite dès qu'on l'utilise pour de vrai. Il faut prévoir un plan payant si l'agent tourne toute la journée.
Concrètement : dans le tableau de bord ElevenLabs, section API, on crée une clé en activant quatre permissions (text-to-speech, speech-to-speech, speech-to-text, voices). Cette clé va dans un fichier .env local, le coffre-fort de secrets que le navigateur consulte à chaque appel serveur sans jamais l'exposer dans le code visible. On choisit ensuite une voix dans la bibliothèque ElevenLabs, on copie son identifiant, et on le colle dans le même fichier.
Le problème qui saute aux yeux tout de suite : Hermes répond parfois en pavés de deux cents mots. Envoyer tout le texte d'un coup à ElevenLabs, attendre le fichier audio complet, puis le lire : ça casse complètement l'effet assistant vivant, le silence dure plusieurs secondes avant la première syllabe.
La solution tient en une phrase : découper la réponse en petits morceaux, envoyer chaque morceau à ElevenLabs dès qu'il est prêt, et streamer l'audio au fur et à mesure qu'il arrive. La première syllabe part avant même que la dernière phrase du texte soit entièrement écrite.
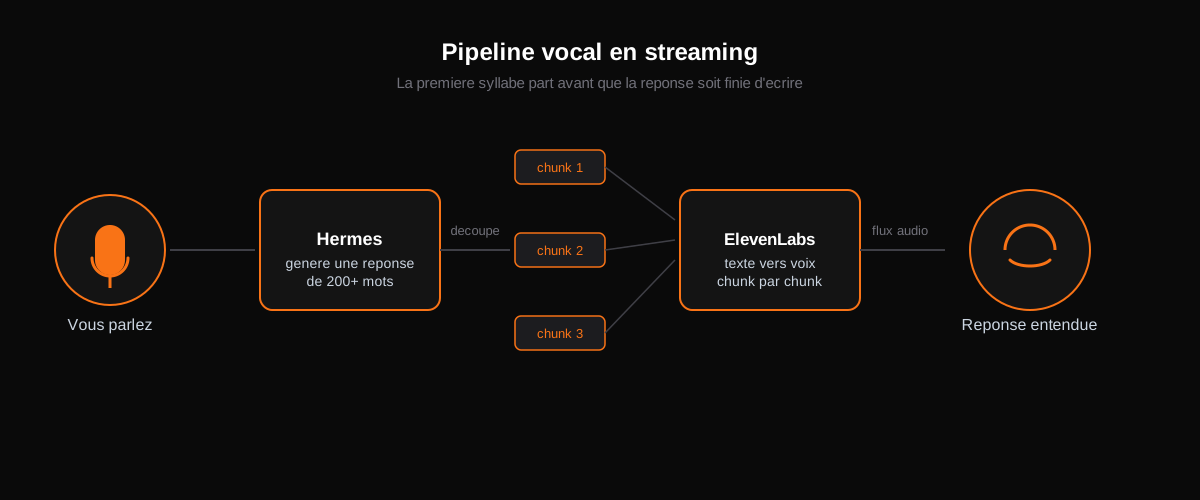
Ce découpage crée un problème inverse. Si on demande à l'agent de rédiger un article de blog complet, il va vouloir le lire à voix haute, du premier au dernier mot. Personne n'a envie d'écouter huit cents mots debout devant son écran. D'où un bouton "kill voice" sur l'interface, qui coupe instantanément toute génération et lecture audio en cours. On a la confirmation que la tâche est faite, on n'a pas besoin d'entendre le roman.
Le panneau de contrôle : voir ce que l'agent fait sans avoir à le lire
Le dernier étage, celui qui transforme un gadget qui parle en vrai centre de commande, c'est le panneau de mission.
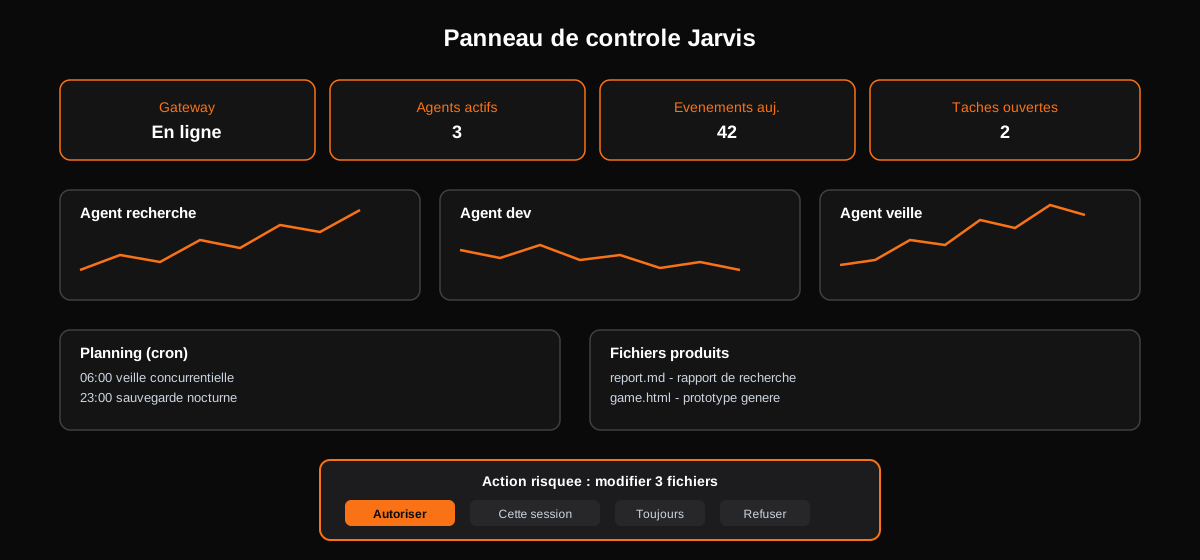
En haut, des cartes de vue d'ensemble : le serveur est-il en bonne santé, combien de profils d'agents actifs, combien d'événements aujourd'hui, combien de tâches ouvertes. À côté, une carte par agent avec un mini-graphique d'activité, pour repérer d'un coup d'œil lequel a été le plus sollicité. Le tableau de bord d'une voiture : on n'a pas besoin de le lire, juste de le regarder.
Les commandes rapides permettent de piloter sans taper de phrase complète :
- une commande de personnalité change le ton et le comportement de l'agent
- une commande de tâche de fond lui donne un nouveau travail sans interrompre le premier
- une commande d'objectif lance une mission longue et complexe, celle qui a produit le rapport de recherche
Une carte planning liste les automatisations récurrentes, et un navigateur de contenu affiche les fichiers déjà produits, ouvrables en un clic directement dans le tableau de bord.
Le point qui rend tout ça sûr à brancher sur une vraie activité : chaque action risquée (modifier un fichier, envoyer un message) déclenche une fenêtre de validation. Autoriser une fois, autoriser pour la session, toujours autoriser, ou refuser. Rien de dangereux ne se produit sans un "oui" explicite.
La preuve : une journée de recherche en vingt minutes
Le test le plus parlant reste la mission de fond lancée par commande vocale : identifier les meilleures chaînes YouTube du secteur IA et automatisation, trouver leurs cinq meilleures vidéos, les transcrire, et en tirer les recettes qui marchent.
Vingt minutes plus tard, sans que j'aie touché à quoi que ce soit : cinquante vidéos passées en revue, dix créateurs couverts, trente-quatre transcripts extraits, et un rapport complet avec méthodologie, patterns récurrents et synthèse actionnable. Ce genre de travail de recherche, fait à la main, c'est la meilleure partie d'une journée de travail qui disparaît.
Pourquoi c'est un produit, pas juste un bricolage du dimanche
Ce que la plupart des gens qui montent ce genre de système pour s'amuser ratent, c'est que c'est vendable tel quel.
Regardez qui galère aujourd'hui. Des agences, des entreprises de service, des équipes qui vivent avec douze onglets ouverts en permanence, et qui paient un assistant virtuel deux mille euros par mois pour exactement ce type de travail toujours actif. Construire ce même centre de commande, branché sur l'agent d'un client, c'est un livrable en soi. L'argument tient en une phrase : vous parlez à votre entreprise, elle vous répond.
Ce que ça change vraiment
Le vrai changement n'est pas dans l'intelligence du modèle. Il est dans ce qu'on demande à un agent de faire de lui-même, une fois qu'on arrête de lui donner des instructions ligne par ligne et qu'on commence à lui confier des objectifs.
FAQ : installation et fonctionnement d'Hermes
Comment installer Hermes sur mon ordinateur ?
L'installation d'Hermes est simple et rapide. Sur macOS, Windows ou Linux via WSL2, il suffit d'une commande dans le terminal pour télécharger et installer toutes les dépendances, ou d'utiliser l'application desktop en un clic disponible sur le site officiel.
Quels types de tâches Hermes peut-il exécuter ?
Hermes peut effectuer une variété de tâches, telles que rechercher sur le web, piloter un navigateur, écrire et exécuter du code, et gérer des fichiers. Il fonctionne de manière autonome sur un planning automatisé, offrant des fonctionnalités comme la veille concurrentielle ou la sauvegarde.
Est-ce que Hermes nécessite un abonnement pour fonctionner ?
Hermes est un projet open source et fonctionne localement sur votre machine, sans dépendance à un abonnement SaaS. Cependant, si vous choisissez d'utiliser des API externes, des frais peuvent s'appliquer selon le fournisseur.
Ce que je construis avec ça en Direction IA Externalisée
Ce genre de montage, agent local, voix ElevenLabs, panneau de mission, garde-fous d'approbation, c'est exactement le type de brique que j'assemble pour les PME que j'accompagne.
Concrètement, dans le cadre de la Direction IA Externalisée, voici ce qui devient possible :
- Un agent qui tourne sur vos propres serveurs ou postes, sans dépendre d'un abonnement cloud tiers, avec vos données qui ne sortent jamais de chez vous.
- Un pipeline vocal branché sur votre CRM ou votre outil métier, pour piloter des tâches à la voix plutôt qu'en tapant des prompts.
- Des tâches planifiées (veille, reporting, relances) qui tournent pendant la nuit et vous attendent au réveil.
- Un système d'approbation qui garde le contrôle humain sur chaque action sensible, pour que l'automatisation reste un outil et jamais un risque.
Le reste, la formation de vos équipes pour qu'elles pilotent ces agents au quotidien, fait partie du même accompagnement.