Prompt engineering : comment faire taire Opus 5
Il y a un truc que personne n'ose dire sur Opus 5 : c'est le modèle le plus intelligent du marché, et le collègue le plus insupportable avec qui travailler.
Il te répond en douze paragraphes quand deux suffisent. Il place « load-bearing » dans une phrase sur deux. Il assume que tu connais tous les acronymes de ta propre industrie. Et il signe tes commits en te remerciant, comme s'il avait fait le travail à ta place.
La bonne nouvelle : le problème est connu, et Anthropic lui-même a partagé un fix officiel. La meilleure nouvelle : derrière ce fix, il y a un principe bien plus puissant, qui s'applique à tous les modèles qui sortiront après. Opus 6, Opus 7, peu importe.
Le prompt engineering n'est pas mort. Il n'a jamais été aussi rentable. Voici comment j'ai transformé le modèle le plus bavard du moment en ingénieur senior précis, avec deux niveaux de correctifs : le fix officiel d'Anthropic, et la méthode système que j'utilise tous les jours.
Le diagnostic : deux symptômes, une facture
Quand on parle des problèmes d'Opus 5, il faut distinguer deux choses.
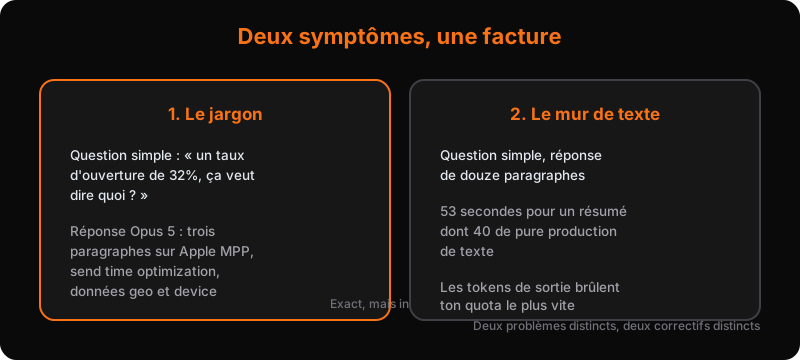
Symptôme 1 : le jargon. Le modèle utilise beaucoup plus de termes techniques et d'acronymes que ses prédécesseurs, et il suppose que tu les connais tous. Exemple vécu : j'ai demandé à Opus 5 ce que signifiait un taux d'ouverture de 32% sur notre dashboard CRM, en précisant qu'un pair m'avait dit que les taux d'ouverture étaient devenus faux. Réponse : trois paragraphes sur Apple Mail Privacy Protection (MPP), la send time optimization, les données géo et device dérivées des ouvertures. Techniquement exact. Humainement inutilisable.
Symptôme 2 : le mur de texte. Pose une question simple, reçois une dissertation. Le pire, c'est que ça coûte : les tokens de sortie sont ce qui consomme le plus vite ton quota, quel que soit ton plan. Un article de blog résumé en 53 secondes dont 40 de pure production de texte, c'est du budget brûlé pour rien.
Ce n'est pas une plainte de niche. Un article qui a fait le tour de X récemment résume le problème en une phrase que je trouve parfaite : « lire la sortie d'une IA aujourd'hui demande un effort supplémentaire ». C'est verbeux, ça contient du non-sens plausible, et c'est de plus en plus dense en jargon.
Le piège, c'est qu'Opus 5 est premier sur les benchmarks (artificialanalysis.ai en tête au moment où j'écris). Donc le problème n'est pas l'intelligence du modèle. C'est son comportement par défaut. Et un comportement par défaut, ça se corrige.
Le fix officiel : l'output style de Claude Code
Anthropic a communiqué un correctif simple pour le problème du jargon. Il tient en un mot : l'output style.
Dans Claude Code, tape /config, et tu tombes sur le réglage « output style ». C'est le style avec lequel l'agent te parle. Par défaut, il est sur « default », le mode verbeux et jargonnant d'Opus 5. Trois autres styles sont livrés d'origine : proactive, explanatory, learning.
Le fix consiste à ajouter ton propre style custom, baptisé ELI5 (Explain Like I'm 5). Pourquoi cet acronyme marche aussi bien ? Parce que les modèles ont été entraînés sur l'intégralité d'internet, y compris le subreddit ELI5 et ses milliers de questions posées dans ce format. Le modèle sait déjà ce que « explique comme si j'avais 5 ans » produit comme niveau de langage. Tu n'as pas à lui apprendre, juste à lui demander.
Tu peux renforcer le style avec une variante plus pro : le standard ASD-STE100, un anglais technique simplifié qui utilise un dictionnaire restreint de mots faciles à comprendre. C'est un standard de l'aéronautique à la base, conçu pour que les consignes de maintenance soient compréhensibles par tout le monde. Appliqué à un agent IA, ça élimine mécaniquement le jargon et les formulations vagues.
Comment l'installer (sans rien taper toi-même)
Le plus simple : colle le prompt du style ELI5 dans Claude Code et demande-lui de l'installer. Il crée le fichier ELI5.md dans ton dossier output styles, met à jour tes settings, et c'est réglé. Ouvre ensuite une nouvelle session et demande-lui quel output style il utilise pour confirmer.
Pourquoi l'output style bat CLAUDE.md
Tu pourrais mettre les mêmes règles dans ton CLAUDE.md. Ça marche, mais c'est moins efficace. Deux raisons :
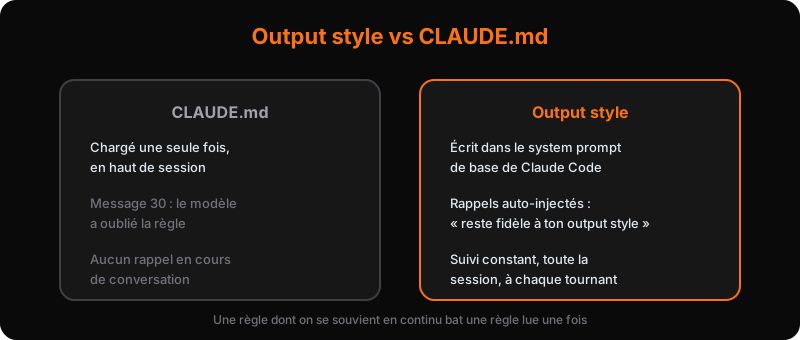
- L'output style est écrit dans le system prompt de base de ton instance Claude Code. C'est la couche la plus profonde, celle qui a le plus de poids.
- Surtout : Claude Code injecte automatiquement des rappels en cours de session du type « reste fidèle à ton output style ». Ton CLAUDE.md, lui, n'est chargé qu'en haut de la conversation. Au bout de trente messages, le modèle l'a oublié. L'output style, on lui rappelle en continu.
Résultat sur le même exemple du taux d'ouverture : la réponse commence par la conclusion (« ce 32% n'est pas composé que de vraies personnes »), raconte pourquoi en clair, et se termine par une phrase que n'importe qui comprend. Plus de MPP non expliqué, plus de geo data.
Les skills anti mur de texte
Pour le mur de texte, attention : ne mets pas de règle de longueur dans ton output style. Sur des travaux de production ou de code, tu as parfois besoin de réponses longues et détaillées. Une règle globale « réponds court » te ferait perdre de l'information quand elle compte.
La bonne granularité, c'est le skill. Trois exemples que j'utilise :
/bro : le plus court du monde, une seule ligne. « Reformule le dernier message en langage humain simple, zéro jargon. » Tu l'invoques quand tu viens de recevoir un pavé, et il le réécrit. Sur l'exemple du 32%, la version /bro donne : « Ce 32% n'a jamais voulu dire que 32 personnes sur 100 ont lu votre email. Voici comment ça marche vraiment. »
wait what? : un skill signé Matt Pocock, à peine plus long. « Je ne comprends pas où tu en es arrivé là. Reformule avec un peu de contexte. » Parfait quand l'agent s'est perdu dans sa propre logique et que tu ne veux pas relire trois paragraphes pour comprendre le raccourci.
/quick : mon skill perso. Tu déclares un nombre, il te sort ce nombre de points essentiels, dans l'ordre. /quick 3 après un pavé, et tu obtiens les trois takeaways sans relire l'essai. Le skill a des règles pour gérer les deux cas : avec nombre, sans nombre.
La leçon : crée tes propres skills plutôt que de copier les miens. Chacun travaille dans son propre contexte, avec ses propres fichiers. Mais les idées se transfèrent : un skill court, une intention unique, invoqué à la demande.
La méthode système : pourquoi le prompt engineering n'est pas mort
Le fix officiel règle le jargon. Pour tout le reste (le style, les tokens, le scope, les tics), il y a une couche plus profonde : le system prompt.
Rappel : tu prompts ton agent de deux façons. Le user prompt, c'est la tâche du moment. Le system prompt, c'est la loi qui s'applique à chaque tâche. Or la plupart des ingénieurs ne touchent jamais leur system prompt. Ils empilent les skills et les commandes slash, et passent à côté du seul endroit où chaque mot écrit est multiplié par chaque prompt utilisateur.
J'ai fait le test proprement : deux instances de Claude Code côte à côte, même tâche (résumer un long article technique), l'une avec le system prompt par défaut, l'autre avec un system prompt que je construis section par section. Voici les six couches, dans l'ordre.
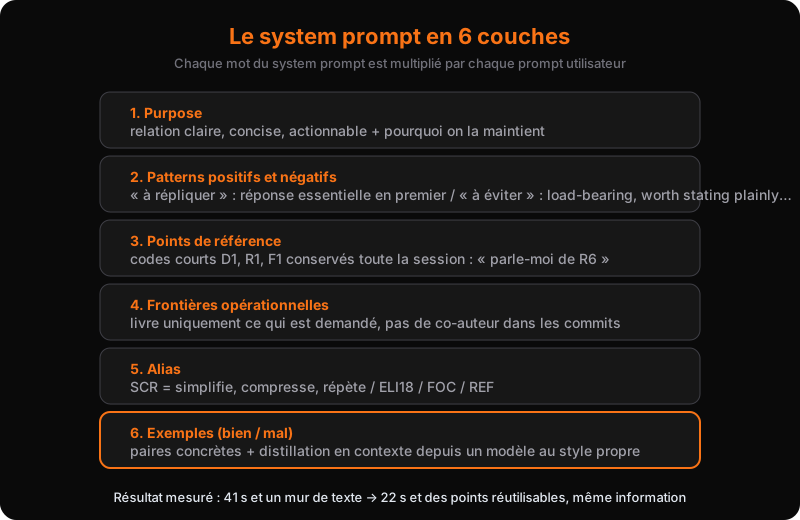
1. Le purpose, et le pourquoi
Pas de rôle, pas de « tu es un expert ». Juste un contrat relationnel : « toi et moi, on maintient une relation claire, concise, actionnable. Chaque mot qu'on échange renforce ce mode de communication. » Et surtout, expliquer pourquoi : « pour livrer les meilleurs résultats possibles à notre équipe, notre business, nos clients. » Les modèles suivent mieux une règle quand ils comprennent sa raison.
2. Les patterns positifs et négatifs
Deux listes. La première, ce que tu veux voir : « je vois toujours la dernière chose que tu écris en premier, place l'information la plus importante là » (comme ça tu peux ignorer le reste si tu veux), « utilise un langage simple et spécifique », « énonce chaque fait une seule fois », « adapte le niveau de détail au niveau de la tâche », « challenge les hypothèses fausses directement, et explique pourquoi ».
La seconde, ce que tu ne veux plus voir. Et là, sois précis. La liste des expressions bannies chez moi : load-bearing, worth stating plainly, here's the honest truth, the real tension, carry the argument. Plus : pas d'analogies, pas d'excès de tirets, pas de flatterie gratuite, pas de titres décoratifs ni d'emojis, pas de point-virgule. Tu as le droit de faire le ménage toi-même : ce sont tes expressions à toi qui doivent figurer là.
3. Les points de référence
Le pattern le plus rentable de tout le prompt engineering, à mon avis. La règle : quand tu présentes trois éléments ou plus (décisions, options, risques, questions, actions, findings), utilise une liste numérotée avec des codes courts. D1 pour les décisions, R1 pour les risques, F1 pour les findings. Conserve les mêmes codes pendant toute la conversation. N'en crée pas pour les réponses courtes.
Le gain est immédiat. Au lieu de « parle-moi plus du risque sur l'auto-amélioration existentielle dont tu parlais au deuxième paragraphe », tu tapes « parle-moi plus de R6 ». L'agent sait exactement de quoi tu parles. Tu ne répètes rien, il ne répète rien, personne ne brûle de tokens. Tu viens de créer un langage privé avec ton agent.
4. Les frontières opérationnelles
Les modèles de pointe ont été entraînés à « trouver la réponse à tout prix ». Opus 5 en est le champion : il trouve et signale des problèmes que tu n'as jamais demandés, il élargit le scope tout seul, et il perd le focus en route. La correction tient en une phrase : « livre uniquement ce qui a été demandé, au périmètre prévu. »
Détaille : ne pas élargir le travail vers du nettoyage, du refactoring ou de la documentation non demandés. Ne pas spéculer sur des abstractions pour des besoins futurs. Ne pas prétendre avoir terminé sans preuve. Ne jamais ajouter de co-auteur aux messages de commit (si, Opus 5 fait ça, et ça devient vite pénible). Et pour le travail terminé, un résumé concis, pas un récapitulatif exhaustif.
5. Les alias
Des raccourcis définis dans le system prompt, comme des alias bash. Tu écris trois lettres, l'agent développe la règle correspondante. Mes quatre de base :
- SCR : simplifie, compresse, répète ta réponse
- ELI18 : explique comme si j'avais 18 ans, simplifie le langage, raccourcis la réponse
- FOC : focus sur ce qui compte vraiment, quel est le vrai signal, quelle est la vraie valeur
- REF : réécris ta réponse avec les points de référence
Règle de sécurité : si l'alias apparaît dans une chaîne plus longue, ce n'est pas un alias, ne le développe pas. Et enchaîner les alias fonctionne : tu peux faire ELI18 puis SCR sur la même réponse pour la compresser en deux passes.
6. Les exemples
La couche finale : des paires concrètes « comment on communique / comment on ne communique pas ». C'est comme fournir des données d'entraînement dans le contexte. Exemple réel : « User : est-ce que le JSON legacy est encore référencé ? Bien : non, le seul match du fichier est lui-même, aucun import, aucune doc ne pointe dessus. Mal : excellente question ! Je vais explorer le repository et... »
J'écrivais ces paires à l'époque de GPT-3.5 et GPT-4. Elles fonctionnent toujours. C'est exactement comme ça qu'on reconnaît une compétence durable : elle marchait il y a trois ans, elle marche encore.
Et il y a l'astuce finale : la distillation en contexte. Démarre un modèle dont tu aimes la façon de répondre (Claude Fable 5, par exemple, qui n'a pas les tics d'Opus 5). Copie sa réponse propre dans ton système comme exemple « bien ». Copie la réponse smartass d'Opus 5 comme exemple « mal ». Nettoie, reformate, et ton agent a désormais un modèle de référence à suivre. Tu transfères le style d'un modèle à l'autre, sans fine-tuning, gratuitement.
Les résultats mesurés
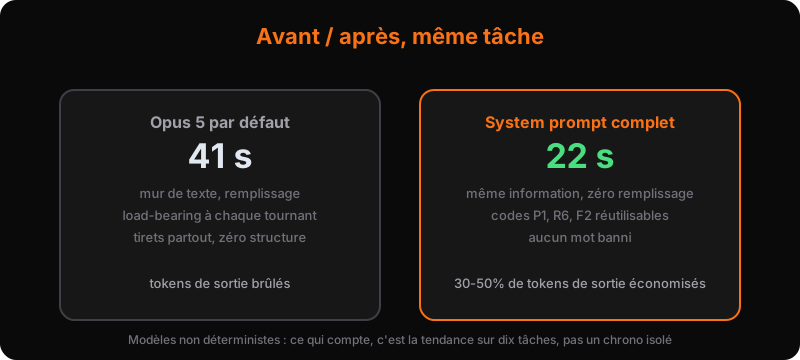
Sur la même tâche de résumé, côte à côte :
- L'instance par défaut : 41 secondes, des paragraphes entiers de remplissage, des load-bearing à chaque tournant, des tirets partout.
- L'instance avec le system prompt complet : 22 secondes, la même information, des points de référence (P1, R6, F2) que je peux réutiliser dans la suite de la conversation, et plus un seul mot banni.
Presque deux fois plus rapide, pour le même contenu utile. Et je rappelle que les tokens de sortie sont la partie la plus chère de ta consommation : à chaque réponse raccourcie, tu récupères du quota. Sur un usage quotidien intensif, c'est de l'ordre de 30 à 50% de tokens de sortie économisés, selon le type de tâches.
Attention à une chose : les modèles ne sont pas déterministes. Une exécution peut être plus rapide qu'une autre sans raison. Ce qui compte, c'est la tendance sur dix tâches, pas le chrono d'une seule.
La leçon que je retiens
Certains disent que le prompt engineering est mort, parce que les gros modèles n'ont plus besoin de prompts hyper structurés pour bien fonctionner. C'est un contresens. Le fait que Claude Code ait raccourci son system prompt d'origine ne veut pas dire que tu ne devrais pas écrire le tien. Ça veut dire que le constructeur a enlevé le réglage par défaut. Ton comportement à toi, tes exclusions, ton langage privé, tes frontières : personne ne les écrira à ta place.
Et il y a une raison plus profonde : le goulot d'étranglement, c'est toi. Sur une journée d'agentic work, le modèle n'est presque jamais la limite. C'est la vitesse à laquelle tu arrives à communiquer avec lui, à trier ce qui compte, à décider où investir ton attention. Un ingénieur qui sait écrire un system prompt communique dix fois plus vite avec son agent qu'un autre qui empile les skills au hasard.
La grande ingénierie, c'est la grande communication. Avec ton équipe, avec tes agents, et avec toi-même. C'était vrai il y a quinze ans, c'est devenu littéral : on code maintenant par la conversation.
Et si tu veux que quelqu'un installe tout ça à ta place (output styles, system prompts, skills maison, les bons modèles au bon endroit), c'est précisément le genre de chantier qu'une direction IA externalisée prend en charge. Un audit offert de 45 minutes suffit pour repartir avec tes trois premiers réglages appliqués.
Voir aussi le glossaire IA
Passez à l'action : votre Audit IA Express offert (45 min)
45 minutes en visio pour auditer vos processus, chiffrer vos gains de productivité et identifier vos 3 premiers agents IA rentables.
Réservé aux dirigeants de PME (10 à 100 salariés) · Sans engagement · Propriété 100 % de vos livrables
Déployez vos agents IA en entreprise avec un expert dédié
Un Directeur IA externalisé vient dans votre PME de 1 à 10 jours par mois pour automatiser vos processus, concevoir vos agents et former vos équipes. Dès 990 € HT/mois, sans engagement au-delà de 30 jours.
Recevez notre synthèse IA hebdomadaire
Chaque vendredi, recevez notre sélection d'articles, études de cas et retours d'expérience terrain sur les Agents IA et l'automatisation B2B. Résumé 100% concis, sans spam.
Direction IA Externalisée en région