Claude Code + Obsidian ne remplace pas le RAG : le vrai problème
« Claude Code + Obsidian remplace le RAG. »
La phrase tourne en boucle depuis des semaines. Sur le papier, c'est magnifique : un dossier de notes Markdown reliées entre elles, un knowledge graph qui se dessine tout seul, dix minutes de setup. On croit avoir réglé la recherche documentaire à vie.
Reste que cette approche a été pensée pour un usage très précis : un second cerveau personnel. Pas pour indexer les documents d'une entreprise, servir plusieurs utilisateurs, et rester fiable à l'échelle.
J'ai testé le concept sur un vrai cas de RAG métier. Voici ce qui se passe réellement quand on pousse cette approche au-delà de la démo.
Le test : des notices techniques, un graphe, une question simple
J'ai donné à Claude Code une dizaine de documents techniques, le genre de doc qu'un atelier de maintenance de bateaux utilise au quotidien : la recherche de panne, les diagnostics possibles, les équipements, les pièces, les remèdes. Le tout configuré comme dans la méthode que j'ai détaillée dans cet article sur le déploiement d'un LLM Wiki avec Claude Code et Obsidian.
Claude Code génère ses notes, crée les wiki-links, et dessine un graphe. Sur l'écran, ça claque. Des clusters apparaissent, des entités se relient, l'ensemble a l'air structuré. C'est le moment où l'on se dit que ça change la donne.
Puis vient une question volontairement banale : « Mon moteur change de régime tout seul. Quel est le diagnostic ? »
Réponse générée : prise d'air dans le circuit, filtre à carburant encrassé, collecteur d'échappement calaminé, hélice sale. Des causes possibles, oui. Mais pour ce symptôme précis, la notice dit autre chose : quand deux moteurs se désynchronisent, la cause probable est un câble de commande mal réglé ou grippé, une course de câble push-pull trop courte, une commande électrique défaillante. On ne lui a donné aucun indice, et il est passé à côté. Avec des indices, il finit par citer les bonnes causes, mais les remèdes autour de la synchronisation restent absents de la réponse.
Le document de référence pour ce cas (page 132 de la notice) contenait tout ça. L'assistant est allé regarder du côté de cette doc sans remonter ce qu'il fallait. Résultat : une réponse longue, pas fausse en soi, mais à côté de la cible. Une hallucination partielle, sur un cas où le technicien doit retrouver la bonne procédure en quelques secondes.
Ce n'est pas un bug. C'est structurel. Il y a trois raisons à ça.
Pourquoi le contexte pourrit, et pourquoi ça coûte cher
Premier problème : la taille du contexte.
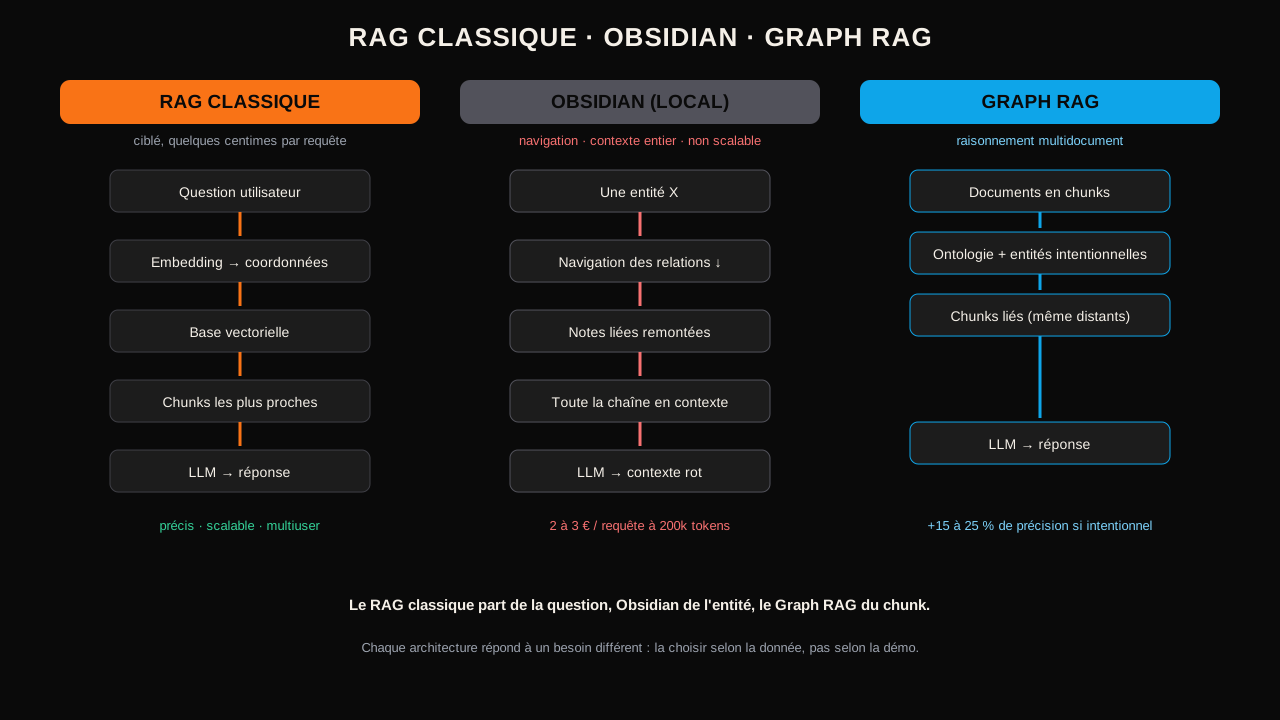
Un RAG classique fonctionne comme ça. Je prends la question, je la passe dans un modèle d'embedding qui lui attribue des coordonnées dans un espace à plusieurs milliers de dimensions, je cherche dans ma base vectorielle les passages dont les coordonnées sont proches. Je sélectionne quelques morceaux pertinents, et je ne donne que ça au LLM. Peu de tokens, donc : une réponse précise, une requête qui coûte quelques centimes.
Obsidian fonctionne à l'envers. L'IA ne cherche pas des passages proches : elle navigue dans la structure des notes, suit les relations, et fait passer toute la chaîne en contexte pour produire la réponse. Sur une petite base, ça marche. Mais une base vit, elle grandit tous les jours (le Web Clipper notamment). La fenêtre de contexte se remplit à chaque requête, et la facture avec.
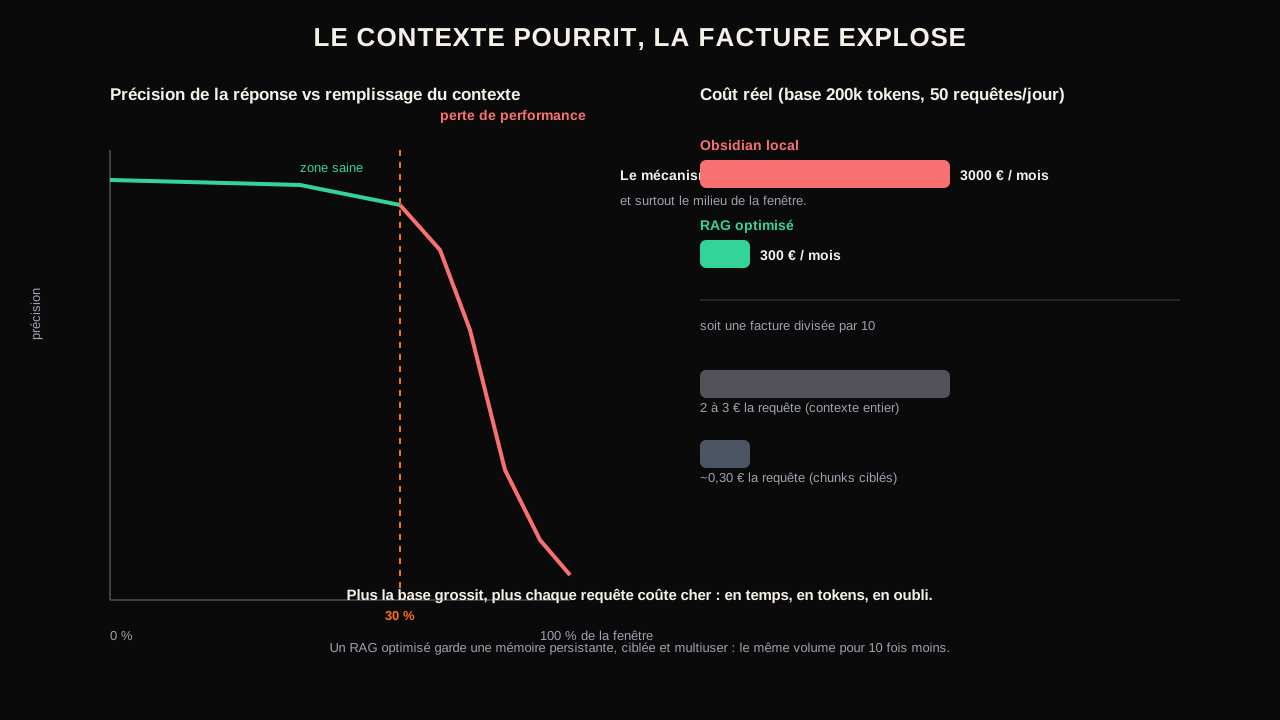
Les LLM reposent sur un mécanisme d'attention. Au-delà de 30 % de remplissage de la fenêtre de contexte, la performance baisse. Plus vous ajoutez de contexte, plus le modèle oublie, surtout ce qui se trouve au milieu. C'est le contexte rot : la pourriture de contexte. Plus votre base grossit, plus chaque requête coûte cher, en temps et en argent.
Prenons un chiffre concret. Une requête sur une base qui charge 200 000 tokens de contexte, c'est environ 2 à 3 €. Cinquante requêtes par jour dans une équipe, c'est environ 3 000 € par mois, chaque mois. Et le chaos s'en mêle : les entités générées automatiquement se contredisent, l'ensemble devient illisible.
| Obsidian local | RAG optimisé | |
|---|---|---|
| Coût par requête (200k tokens) | 2 à 3 € | ~0,30 € |
| Facture mensuelle (50 requêtes/j) | ~3 000 € | ~300 € |
| Contexte | Se remplit, pourrit | Ciblé, fractionné |
| Utilisateurs | Un seul, local | Multiuser natif |
| Passage à l'échelle | Bloque vite | Monte proprement |
Pour le même volume, on divise la facture par dix. Et on garde une mémoire persistante qui se met à jour sans tout rejouer.
L'autre blocage, c'est le fameux « local ». Obsidian a été conçu pour un usage personnel, pas pour une équipe, pas pour un produit, pas pour la production. Le multiuser y devient un cauchemar.
Knowledge graph et graph RAG : ne pas mélanger les concepts
Le mot « graph » balade tout le monde. Un knowledge graph et un graph RAG, ce n'est pas la même pièce.
Le knowledge graph, c'est de la navigation manuelle : des entités, des clusters, des notes reliées. Je veux savoir ce que Jean aime, je suis la relation « aime » et je tombe sur les pommes, les fraises, le foot. C'est de l'exploration ciblée, descendante, depuis une entité.
Le graph RAG, lui, part du contenu. Il découpe les documents en chunks, puis crée des relations entre chunks à partir d'une ontologie et d'entités intentionnelles. Tu poses une question, un chunk remonte, et le système va chercher tous les chunks liés, y compris ceux qui sont sémantiquement plus éloignés mais dont on a besoin pour la complétude. C'est précieux quand on raisonne sur plusieurs documents à la fois.
Obsidian fait l'inverse du graph RAG. Il part du graphe global, d'une entité X, et navigue de haut en bas dans les relations pour ramener des notes. Ça marche pour une question factuelle courte sur une petite base. Pour un raisonnement multidocument, c'est le mauvais outil au mauvais endroit.
Le vrai problème : des entités générées sans logique métier
Encore plus profond, il y a la génération automatique d'entités. C'est là que ça part en vrille.
L'IA crée des entités basées sur la proximité textuelle, pas sur la logique métier. Trois dérapages classiques :
-
Les homonymes deviennent des entités distinctes. « Apple » le fruit, « Apple » l'entreprise, peut-être même une coquille « Applle » : trois nœuds séparés. Une question « combien Apple a vendu en 2024 » ramène des pommes au milieu des résultats. L'explosion combinatoire des relations fausses pollue toute la recherche.
-
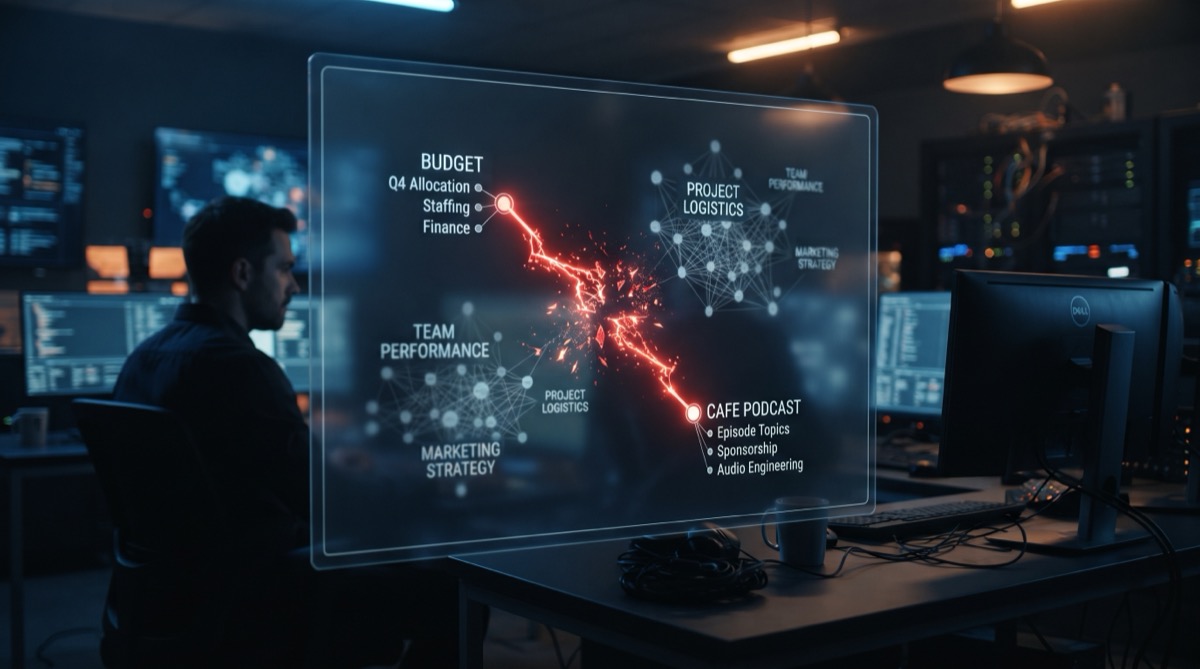
Les relations naissent du hasard textuel. Un rapport marketing mentionne le mot « budget », et dans la même liste stratégique figure une note « podcast café ». L'IA crée un lien entre budget et podcast café. Plus tard, une requête sur les boissons fait remonter le podcast café, donc le budget, donc tout le reste. Le LLM se dépatouille avec un bruit croissant, et le contexte sature.
-
Aucune normalisation. « ROI », « retour sur investissement », « rentabilité » : trois entités pour un même concept. Au lieu d'un nœud qui regroupe tous les sujets liés à la rentabilité, on obtient une fragmentation des relations. Une requête sur la rentabilité rate les documents indexés sous « ROI », et inversement.
À l'échelle, le résultat est un graphe pollué par des faux positifs. Un graph RAG bien construit augmente la précision d'un RAG classique de 15 à 25 %. Mais à une seule condition : que les entités et les relations soient intentionnelles, posées sur une ontologie, et non inventées par le modèle à la volée.
Pour la plupart des projets, la recette la plus solide reste un modèle de données simple et assumé. Sur un cas de maintenance : l'entité « symptôme », puis « cause possible », « diagnostic à réaliser », « solution », « équipement ». Chaque chunk porte la bonne métadonnée, la page, le document d'origine. La matrice est courte, maintenable, et elle se scale sans se dégrader.
SQL, vector search, graph RAG : chacun son terrain
Il n'y a pas une bonne architecture. Il y a la bonne architecture pour la donnée qu'on traite.
- Donnée structurée : la récupération SQL est imbattable. Une base de pannes stockée dans Airtable ou Postgres se fouille par requête, pas par embedding.
- Hybride SQL + vector search : c'est 80 % des RAG en production, et c'est ce qui donne les meilleures précisions. Le SQL filtre le périmètre, la recherche vectorielle trouve les passages proches.
- Graph RAG : réservé au multidocument où les relations sémantiquement éloignées comptent pour la complétude de la réponse. Jusqu'à 15 à 25 % de précision en plus quand il est bien construit, du bruit partout quand il ne l'est pas.
FAQ : Claude Code et Obsidian vs RAG
Pourquoi Claude Code et Obsidian ne fonctionnent-ils pas pour indexer les documents d'une entreprise ?
Claude Code et Obsidian sont conçus pour un usage personnel, ce qui limite leur capacité à gérer des documents d'entreprise et à servir plusieurs utilisateurs de manière fiable. Cela les rend peu adaptés pour des applications professionnelles à grande échelle.
Quels sont les coûts associés à l'utilisation d'Obsidian par rapport à un RAG optimisé ?
Utiliser Obsidian peut coûter jusqu'à 3 000 € par mois pour 50 requêtes par jour, contre environ 300 € par mois avec un RAG optimisé. La différence de coût résulte de la manière dont le contexte est géré.
Qu'est-ce que le problème de la 'pourriture de contexte' dans les systèmes basés sur Obsidian ?
La 'pourriture de contexte' se produit lorsque le modèle perd de l'efficacité en raison d'un trop grand remplissage de la fenêtre de contexte. Cela entraîne des réponses moins précises et des coûts plus élevés à mesure que la base de données se développe.
La méthode qui tient la route
Passer d'une démo à un système en production impose un chemin sans magie :
- Audit des données. Comprendre la logique métier et les relations entre les entités du cas d'usage avant d'écrire une ligne de pipeline.
- Data model. Poser l'ontologie, les concepts et leurs liens, avec l'équipe métier.
- Pipelines d'ingestion. Transformer les documents et la documentation en base requêtable, souvent vectorielle.
- Pipelines de récupération. Construire la passerelle entre la question et les chunks retenus.
- Interface. Mettre le résultat derrière une expérience utilisateur qui cache la mécanique.
Les phases 2 et 3 sont les plus importantes. C'est là que tout se joue, et c'est là que les démos s'effondrent : pas au moment de la requête, mais à l'ingestion, quand il faut décider ce qu'on garde, comment on le découpe, et quelles relations on accepte.
Obsidian reste un excellent outil pour prendre des notes reliées et en faire un second cerveau utilisable au quotidien. Pour indexer et interroger la connaissance d'une entreprise, c'est autre chose. L'expertise n'est plus dans le choix du modèle. Elle est dans la distribution du travail entre la base, le graphe et le LLM.
C'est précisément ce que fait une Direction IA Externalisée : poser un data model solide, construire les pipelines d'ingestion, et mettre en production un assistant qui répond juste, à partir de 990 € HT/mois.
Si vous voulez savoir ce que vos données peuvent donner en vrai assistant métier, testons-le sur un cas concret. L'Audit IA Express est offert, 45 minutes, sans engagement : il suffit de réserver ici.
Un terme IA croisé dans cet article ?
Définitions claires, sans jargon, pour dirigeants de PME.
Audit IA offert · 45 min
Passez à l'action : votre Audit IA Express offert (45 min)
45 minutes en visio pour auditer vos processus, chiffrer vos gains de productivité et identifier vos 3 premiers agents IA rentables.
Réservé aux dirigeants de PME (10 à 100 salariés) · Sans engagement · Propriété 100 % de vos livrables
Relevé hebdomadaire des Agents & Automatisations IA
Chaque samedi matin, recevez notre sélection d'articles, retours d'expérience terrain et cas d'usage concrets sur les Agents IA en PME. Synthèse directe, zéro superflu.
Direction IA Externalisée en région